AI駆動開発の要件定義!炎上を防ぐ5つの定義項目と発注側の役割

AI駆動開発、つまり要件定義から開発、運用までの工程で生成AIを積極的に活用する手法が広がっています。一方で、開発がPoC止まりで終わったり、検収の段階で受発注双方が揉めたりするケースも後を絶ちません。
その原因の多くは、開発の工程ではなく要件定義の段階に潜んでいます。AIの出力品質は「コードの正しさ」ではなく「データの質と量」に左右されるため、従来のように仕様を先に固める進め方が機能してくれないのです。
本記事では、なぜ従来の要件定義がAI開発で通用しないのかを整理したうえで、要件定義で必ず定義しておきたい5つの項目、発注側とベンダーの分担の境界線、そして要件定義の失敗が炎上に直結する3つのパターンを解説します。
AI開発をこれから検討する方も、過去に失敗した経験がある方も、要件の段階で何を決めておくべきかがわかるはずです。
なぜ従来の要件定義がAI開発で機能しないのか
従来のウォーターフォール型要件定義は「完成形を先に確定し、その通りに作る」前提で設計されています。AI開発では、この前提が崩れてしまいます。
理由は、AIの出力品質が「コードの正しさ」ではなく「データの質と量」に左右され、それが要件定義の時点では確定できないからです。結果として、一度固めた仕様が開発途中で覆ってしまうことが珍しくありません。
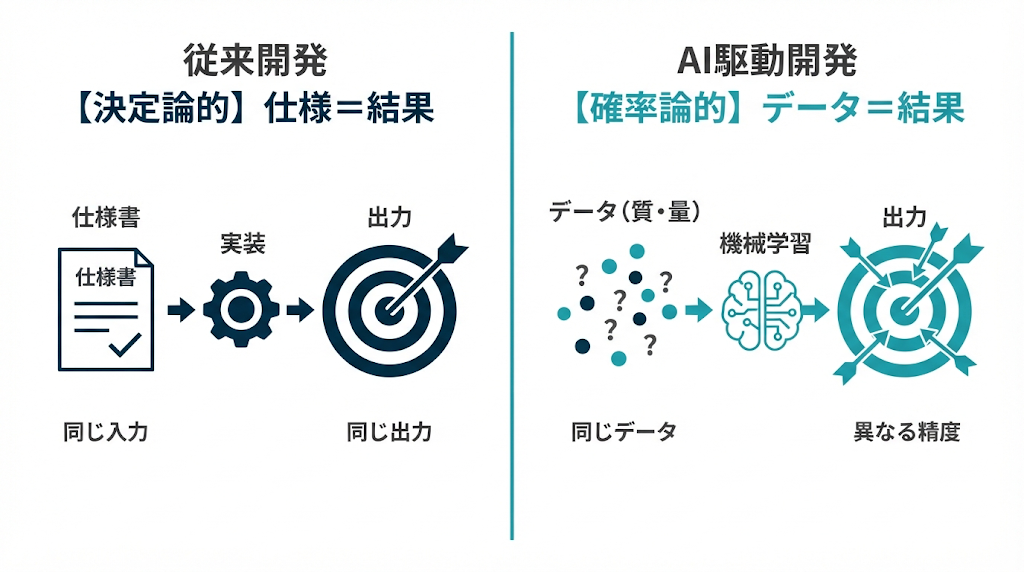
「仕様を固めてから開発する」前提がAIでは成立しない理由
従来開発では、入力に対する出力が決定論的でした。つまり同じ入力なら必ず同じ出力が返るということ。仕様書に「ボタンを押すと画面Aに遷移する」と書けば、実装もその通りに動いてくれます。
一方でAIモデルの出力は確率論的です。同じ業務データを学習させても、データの分布や前処理、パラメータによって精度が変わってしまうため、「何ができるか」を実装前に断定することはできません。
| 比較軸 | 従来開発 | AI駆動開発 |
|---|---|---|
| 出力の性質 | 決定論的(仕様=結果) | 確率論的(データ=結果) |
| 仕様確定のタイミング | 開発着手前に確定 | PoC後に暫定確定 |
| 「動く」の定義 | 仕様通り動作 | 業務要件の精度ラインを満たす |
| 失敗の主因 | 実装ミス・仕様漏れ | データ不足・精度未達 |
この差異を無視して仕様を先に確定してしまうと、「仕様書には書いてあるが、データ的に実現できない機能」が発注書に残り、検収の段階で行き詰まってしまうでしょう。
要件定義時点でデータの品質・量が不明なままになりやすい
AIの精度は学習データによって決まります。ところが多くの企業では、要件定義の段階で自社データの実態をつかめていないのが実情です。典型的な不明点は、以下の3つです。
第一に、データの「量」。何件あれば目標精度に届くのかは、データの分散やタスクの難易度によって変わるため、実際に集めてみるまで確定できません。
第二に、データの「質」。欠損や表記揺れ、ラベルの誤りがどれくらい混ざっているのかは、クレンジングに着手して初めて見えてきます。
第三に、データの「継続供給性」。PoCで集めたデータと、本番運用で発生するデータの分布が一致する保証はないのです。
PoCの段階でデータを収集していた場合でも、本開発ではさらに多くのデータが必要になることは少なくありません。継続的にデータを取得できる体制を整えるため、ビジネスオペレーション側にまで踏み込む必要が出てくることもあります。こうした事情から、AI開発の要件定義は「一度で固める文書」ではなく、「データの実態が判明するたびに更新していく文書」として捉えておくとよいでしょう。
PoCで得た結果が要件を覆す「仕様漂流」を防ぐためには
仕様漂流とは、PoCの結果によって当初の要件が次々と書き換わり、プロジェクトの輪郭が定まらなくなる現象のこと。これを防ぐには、要件を無理に固定するのではなく、「どこが変動し、どこが不変か」をあらかじめ分けておくことが効果的です。
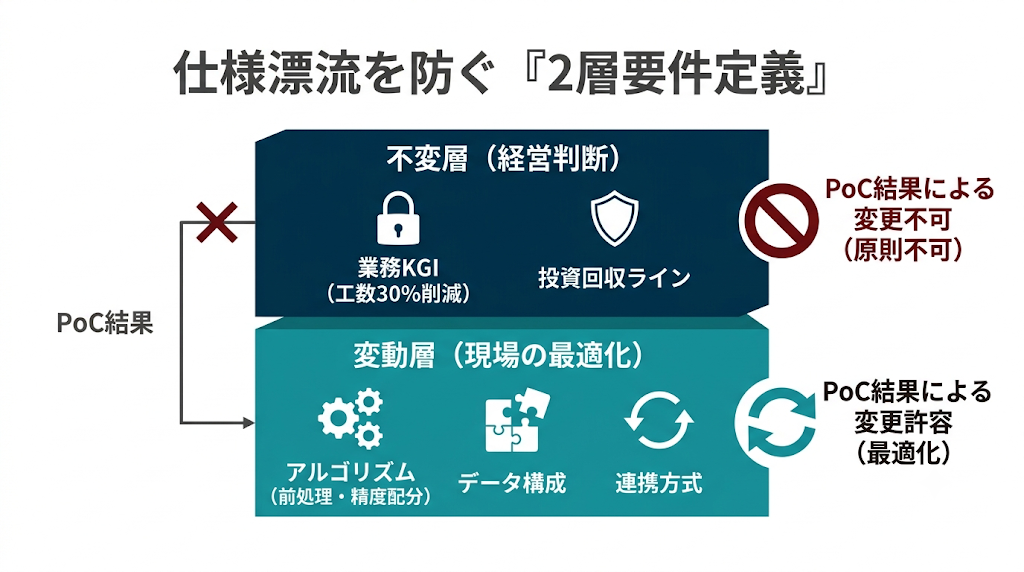
EPICsでは、要件を2つの層に分けています。不変層は「達成したい業務KGI(例えば問い合わせ対応工数の30%削減)」。変動層は「それを実現する技術手段や精度配分、データ構成」です。PoCで覆ってよいのは変動層だけとし、不変層を変える場合には発注側の意思決定を必須とする運用にしています。
| 層 | 内容 | PoC結果による変更 |
|---|---|---|
| 不変層 | 業務KGI・投資回収ライン・適用業務範囲 | 原則不可(経営判断を要する) |
| 変動層 | アルゴリズム・前処理・精度配分・連携方式 | 許容(PoCで最適化) |
このように分けておくと、PoCの結果が出るたびに「何を再合意すべきか」が明確になり、漂流が「想定内の調整」に変わっていくはずです。
成功基準を数値で定義できていない要件書は危険である
「精度を高くする」「業務を効率化する」といった定性的な記述しかない要件書は、検収のときに必ず揉めてしまいます。発注側は「期待に届いていない」と主張し、ベンダーは「定義された範囲で動作している」と反論するため、合意できる地点が見つからないのです。
数値化しておきたい基準は、最低でも以下の3点です。
第一に、精度の合格ライン(例えば適合率90%以上、再現率85%以上)。タスクによって重視すべき指標が変わるため、精度という言葉ではなく、具体的な評価指標で定義しておきましょう。第二に、処理速度(例えば1件あたり推論3秒以内)。第三に、業務効果(例えば従来30分の作業を5分に短縮)です。
成功基準を数値で固定しておく効果は、検収を客観化できることだけではありません。「その数値に届くだけのデータが本当に存在するのか」という逆算が働くため、データ要件の不足を要件定義の段階で気づけるようになります。
数値基準が抜け落ちているということは、後続の全工程に潜むリスクを、要件定義の時点で見逃してしまうことと同じだと言えるでしょう。
AI駆動開発の要件定義で定義すべき5つの項目
AI開発の要件定義は、従来の機能一覧だけでは足りません。データや精度、運用、連携といった、従来は設計工程以降で扱っていた論点を、要件の段階で確定させておく必要があります。定義しておきたいのは、以下の5項目です。
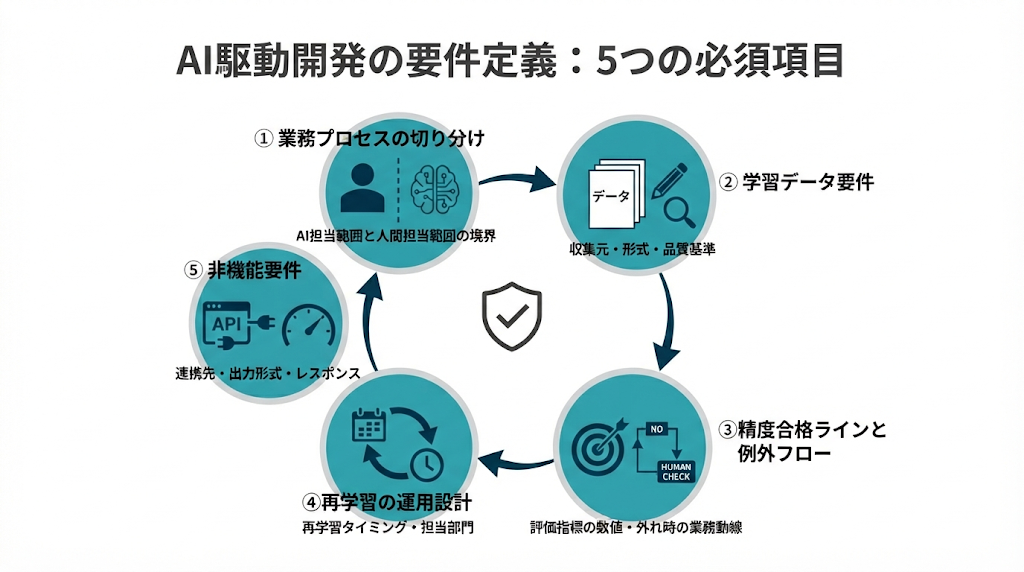
| 項目 | 確定すべき内容 | 未定義時のリスク |
|---|---|---|
| ①業務プロセスの切り分け | AI担当範囲と人間担当範囲の境界 | 責任所在の不明確化、現場の不信 |
| ②学習データ要件 | 収集元・形式・品質基準 | 精度未達、開発中断 |
| ③精度合格ラインと例外フロー | 評価指標の数値・外れ時の業務動線 | 検収紛糾、運用停止 |
| ④再学習の運用設計 | 再学習タイミング・担当部門 | 精度劣化の放置 |
| ⑤非機能要件 | 連携先・出力形式・レスポンス | 既存システムと接続不能 |
AIが介入する業務プロセスと人が担う範囲を切り分けられているか
AIにすべての工程を委ねる設計は、確率論的な出力という性質上、現実的ではありません。要件定義では「業務プロセスのどの判断をAIが担い、どこで人間が介在するのか」を工程ごとに切り分けておきましょう。
切り分けの基準となるのは、誤りが業務に与える影響の大きさです。誤った出力が金銭や安全、法令に直結する判断は人間が最終承認することとし、AIは候補の提示にとどめます。影響が小さく件数の多い判断であれば、AIに自動処理を委ねていく形が効果的でしょう。
技術的に高精度なAIを開発できても、現場で使われないケースは少なくありません。その分かれ目になるのは、アルゴリズムの性能ではなく、「ユーザーがどのタイミングで、どんな判断材料としてAIを使うのか」という業務動線の設計です。
この切り分けを要件の段階で固めておかないと、完成後に「結局すべて人間が確認する」運用になってしまい、投資した効果が消えてしまいます。
学習データの収集元・形式・品質基準を明文化できているか
データ要件は、AI開発における最大の変数となります。明文化しておきたいのは、収集元・形式・品質基準の3点です。
収集元については、「どの部門の、どのシステムから、どの権限で取得するのか」を特定しておきましょう。部門ごとにデータの所有権が分かれている場合、収集の合意を取りつけること自体に時間がかかるため、要件の段階で確定させておくことが前提となります。
形式については、構造化データ(表形式)なのか非構造化データ(画像・テキスト・音声)なのかで前処理の工数が桁違いに変わるため、混在の比率まで記述しておくとよいでしょう。品質基準については、欠損率やラベル付与のルール、表記統一の許容範囲を数値で定めておきます。
| データ要件 | 明文化する内容 | 確認方法 |
|---|---|---|
| 収集元 | 部門・システム・取得権限 | データオーナーへの権限確認 |
| 形式 | 構造化/非構造化の比率 | サンプル抽出による実査 |
| 品質基準 | 欠損率・ラベル精度・表記ルール | 数百件のサンプル検証 |
品質基準を「後で詰める」としてしまった要件書は、開発に着手したあとクレンジングだけで想定の数倍の工数を消費し、スケジュール全体を破綻させてしまいます。
精度の合格ラインと「AIが外れたときの業務フロー」を決めているか
精度100%のAIは存在しません。要件定義で決めておきたいのは、合格ラインと「外れた残りの数%をどう処理するか」の2点です。後者が抜け落ちていることが、運用破綻の典型的な原因となっています。
合格ラインは、タスクに応じた評価指標で定義しましょう。見逃しが許されない検知系(不良品や異常の検知)であれば再現率を、誤検知のコストが高い分類系であれば適合率を優先します。「精度95%」という単一の数値では、どちらの誤りを許容するのかが定義されないため、運用要件として機能してくれません。
外れたときのフローとは、誤った出力を誰がどう拾うのかという動線のことです。具体的には、AIが確信度の低い出力を人間にエスカレーションする閾値、人間が修正した結果を記録する仕組み、その記録を再学習へ回す経路を定義しておきます。
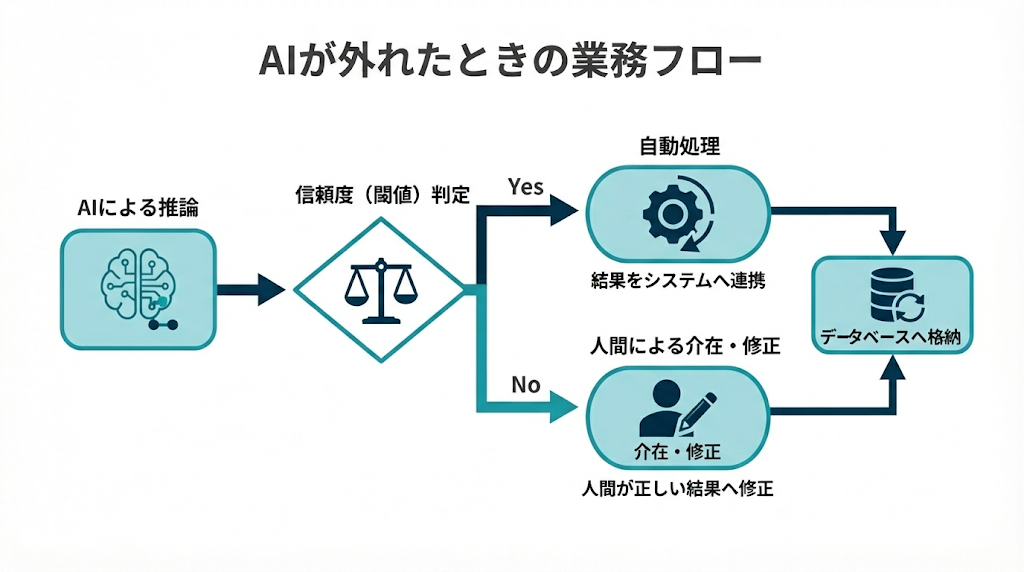
この例外フローを要件に組み込んでおくことで、AIの誤りが業務の停止ではなく「想定内の人間の介在」に変わっていくはずです。
運用後のモデル再学習タイミングと担当部門を要件に含めているか
AIモデルは、運用開始時点の精度をそのまま維持してくれるわけではありません。実世界のデータ分布が時間とともに変化していくためで、これをデータドリフト(データの傾向のずれ)と呼びます。再学習を要件に含めておかないと、精度の劣化が放置され、半年後には使い物にならなくなってしまうこともあります。
要件に組み込んでおきたいのは、再学習のトリガー・担当部門・データ供給経路です。トリガーは「精度が合格ラインを下回ったとき」や「四半期ごと」など、定量・定期の基準で定めておきましょう。担当部門については、運用データを管理する現場部門と、モデルを再学習するベンダーや社内チームの役割分担を明記しておきます。
再学習を運用保守契約に含めるのか、それとも都度発注とするのかは、コストと精度維持のトレードオフとなります。継続契約は固定費が発生するものの精度を担保でき、都度発注は費用を抑えられる一方で劣化の検知が遅れがちです。この選択を、要件の段階で意思決定しておく必要があるでしょう。
システム連携先・出力形式・レスポンスタイムの非機能要件を定義できているか
AIモデル単体がどれだけ高精度でも、既存の業務システムと接続できなければ価値を生みません。非機能要件として、連携先・出力形式・レスポンスタイムを定義しておきましょう。
連携先については、AIの出力を受け取る基幹システムやデータベース、業務アプリを特定し、APIの有無と認証方式を確認しておきます。
出力形式は、後続のシステムが処理できる構造(JSONやCSV、DBへの直接書き込みなど)に合わせておきましょう。レスポンスタイムは、業務の許容範囲から逆算して決めます。リアルタイムの応答が必要な接客系と、夜間バッチで足りる分析系とでは、求められる速度が桁違いとなり、必要なインフラ構成やコストも変わってきます。
| 非機能要件 | 確定事項 | 業務への影響 |
|---|---|---|
| 連携先 | 対象システム・API・認証 | 接続不能なら導入不可 |
| 出力形式 | JSON/CSV/DB書き込み | 後続処理の自動化可否 |
| レスポンス | 同期/非同期・許容秒数 | インフラ構成とコスト |
これらを要件の段階で確定しておくことで、「AIは完成したのに既存システムに繋がらない」という、運用直前の手戻りを避けられるようになるはずです。
誰が要件定義を主導するか|発注側とベンダーの分担境界線
AI開発の要件定義は、ベンダー単独でも発注側単独でも完成しません。業務知識とデータは発注側にしかなく、技術的に実現できるかどうかの判断はベンダーにしかないからです。問題になりやすいのは、両者の境界が曖昧なまま着手してしまい、「相手が決めると思っていた」論点が放置されてしまうこと。
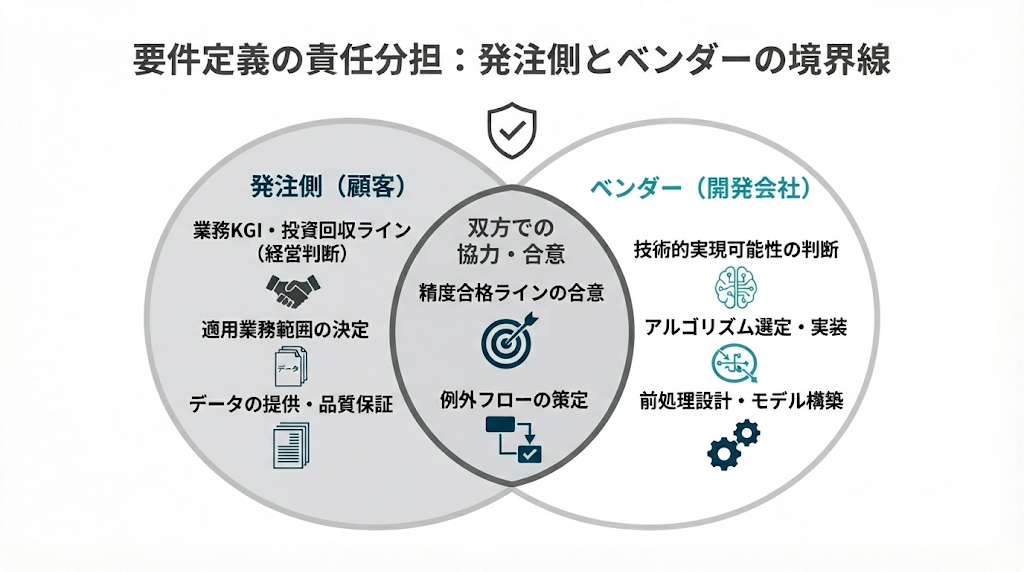
| 領域 | 主導すべき主体 | 理由 |
|---|---|---|
| 業務KGI・適用範囲 | 発注側 | 経営判断・業務知識を要する |
| データの提供・品質保証 | 発注側 | データの所有・実態把握は社内のみ |
| 技術的実現可能性の判断 | ベンダー | データ量と精度の関係を評価可能 |
| アルゴリズム・前処理設計 | ベンダー | 専門知識を要する |
| 精度合格ラインの合意 | 双方 | 業務要求と技術限界のすり合わせ |
発注側が決めなければベンダーも動けない3つの前提条件
ベンダーがどれだけ技術力を持っていても、発注側の意思決定が欠けていると要件定義は前に進みません。発注側が確定させておきたい前提条件は、以下の3点です。
第一に、業務KGIと投資回収ラインです。「どの業務を、どこまで改善すれば投資に見合うのか」は経営判断であり、ベンダーが代わりに決めることはできません。これが曖昧なままだと、後ほど述べる「目的不在型」のプロジェクトに陥ってしまいます。
第二に、データへのアクセス権限です。どの部門のどのデータを、どの範囲で開発に使えるのかは社内の承認事項となります。
第三に、現場の協力体制です。学習データのラベル付けや精度の検証には現場担当者の業務知識が欠かせないため、その工数を誰が負担するのかを発注側が決めておく必要があります。
これら3点が未確定のまま「とりあえず要件定義を」とベンダーに依頼してしまうと、ベンダーは仮定で文書を埋めるしかありません。その仮定が外れた時点で、全面的な手戻りが発生してしまうでしょう。
データオーナーとPMの意見が割れたとき誰が最終判断を下すか
AI開発に特有の対立構造として、データオーナー(データを管理する部門)とPM(プロジェクトの推進者)の利害の衝突があります。PMは精度を上げるために多くのデータを求める一方、データオーナーは個人情報保護や部門の管理負荷、データ提供のリスクを理由に提供を絞ろうとするのです。
この対立は、現場のレベルでは解決できません。データの提供範囲をどこまでにするかは、業務効果とコンプライアンスリスクのトレードオフであり、両者の上位にいる意思決定者が裁定する必要があります。
要件定義に着手する前に、このエスカレーション先(多くは事業責任者やデータガバナンス責任者)を指名しておくことで、プロジェクトの停滞を防げるはずです。
裁定する人が不在のまま着手してしまうと、データ提供の是非が部門間の調整に委ねられ、合意形成だけで数か月かかってしまうことも。開発が始まらないまま、予算と期限を消費してしまいかねません。
外部ベンダーに委ねてよい範囲と社内で保持すべきナレッジの境界線
AI開発を外部に委託する際、すべてをベンダーに委ねてしまうと、運用のフェーズで自社が何も判断できなくなってしまいます。かといって専門領域まで内製しようとすると、今度は開発自体が進みません。委ねる範囲と保持する範囲の境界を設計しておきましょう。
| 範囲 | 委託の可否 | 判断基準 |
|---|---|---|
| アルゴリズム選定・実装 | 委託可 | 専門性が高く内製困難 |
| 前処理・モデル構築 | 委託可 | 開発工数が大きい |
| データの意味・業務文脈の理解 | 社内保持 | 自社業務の根幹であり外部化不可 |
| 精度合格ラインの判断基準 | 社内保持 | 業務要求の源泉 |
| 再学習の要否判断 | 社内主導 | 運用の自立性に直結 |
社内に保持しておきたいナレッジの核となるのは、「なぜこの精度が必要なのか」「どの誤りが業務上致命的なのか」という業務文脈の判断軸です。これを外部に委ねてしまうと、ベンダーを変更したときにプロジェクトが再現できなくなり、特定ベンダーへの依存(ベンダーロックイン)が固定化してしまいます。
EPICsでは、開発の実装はベンダーが担いつつ、判断軸は発注側に残す分担をおすすめしています。こうしておくことで、運用が始まったあとの意思決定を、発注側が自律的に行えるようになるはずです。
要件定義の失敗がAI開発炎上に直結する3つのパターン
AI開発の炎上、つまり予算の超過や納期の遅延、検収できない事態は、開発の工程ではなく要件定義の欠落から起きています。失敗は3つのパターンに分けられ、いずれも要件の段階で検知して回避できるものばかりです。
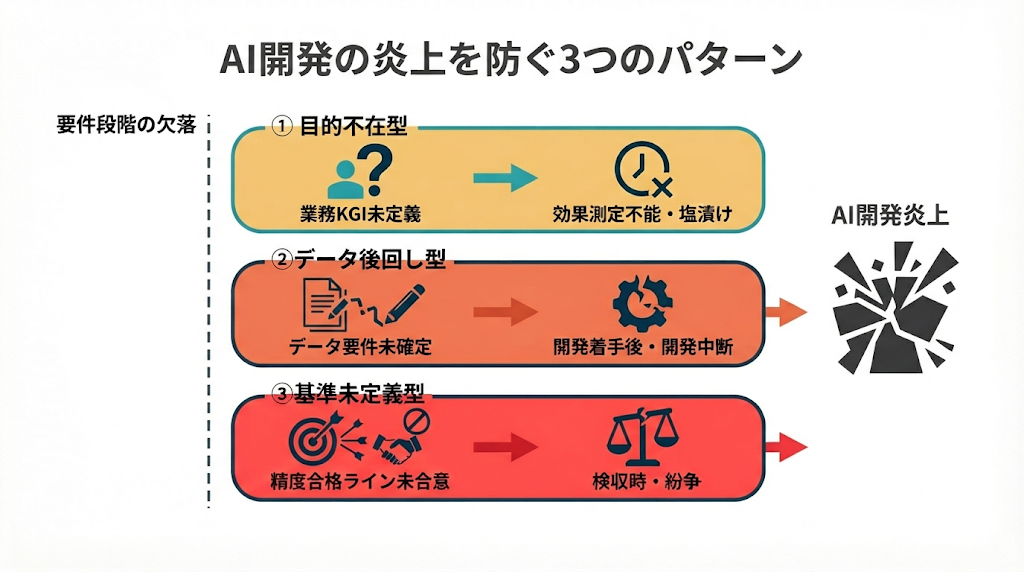
| パターン | 要件段階の欠落 | 表面化する時期 | 帰結 |
|---|---|---|---|
| ①目的不在型 | 業務KGIの未定義 | 検収・運用 | 効果測定不能、塩漬け |
| ②データ後回し型 | データ要件の未確定 | 開発着手後 | 精度未達、開発中断 |
| ③基準未定義型 | 精度合格ラインの未合意 | 検収 | 受発注の紛争 |
「なんとなくAIで効率化したい」という目的不在型プロジェクトの末路
「AIで何かできないか」という起点で始まるプロジェクトには、業務KGIが存在しないため、完成しても成否を判定できないという問題があります。これが目的不在型です。
このパターンがたどる末路は、技術的には動作するAIが完成するものの、「で、これで何が改善したのか」に誰も答えられない状態。効果が数値で測れないため、運用を続けるかどうかの判断材料がなく、再学習の投資判断もできないまま、やがて使われなくなってしまいます。
AIを活用すること自体が目的化してしまい、業務改善という本来の目的が抜け落ちてしまった結果だと言えるでしょう。
これを避けるには、要件定義の冒頭で「どの業務の、どの指標を、どれだけ改善するのか」を数値で固定しておくことです。この数値が定まらないのであれば、それは要件定義ではなくPoC以前の企画検討の段階であり、まだ開発に進むべきタイミングではありません。
データ要件を後回しにして開発着手した結果、何が起きるか
「データは追々用意する」として開発契約を結んでしまうパターンです。AI開発において、これは最も頻度の高い炎上の原因となっています。
開発に着手したあと、事態は段階的に悪化していきます。第一段階では、提供されたデータの欠損や表記揺れが判明し、クレンジングの工数が想定を超えてしまいます。第二段階では、量が精度の目標に足りていないことが判明し、追加で収集する体制の構築が必要になります。第三段階では、収集元の部門の承認が下りず、データの供給そのものが止まってしまうのです。
PoCの段階でデータを収集していた場合でも、本開発ではさらに多くのデータが必要になり、継続的に取得できる体制をビジネスオペレーション側に構築する必要が出てきます。
この体制構築は本来、要件定義で着手しておくべき事項です。開発に着手したあとで発覚してしまうと、開発をいったん止めてデータ整備に数か月戻ることにもなりかねません。データ要件の後回しは、単なるスケジュールの後ろ倒しではなく、プロジェクトの一時停止を意味すると考えておきましょう。
精度の合格基準を決めないまま検収を迎えたプロジェクトはどうなるか
合格基準が要件書にないまま開発を終えてしまうと、検収の段階で受発注の双方の主張がぶつかり合います。
発注側は「期待した精度に達していない」と検収を拒み、ベンダーは「契約の範囲のものは納品した」と完成を主張します。両者の主張を裁定できる客観的な基準が存在しないため、合意できる地点が見つからないのです。結果として、追加開発の費用負担をめぐる交渉が長引き、最悪の場合には法的な紛争にまで発展してしまいます。
| 状態 | 合格基準あり | 合格基準なし |
|---|---|---|
| 検収の判定 | 数値で客観判定 | 主観的な「期待値」で対立 |
| 未達時の対応 | 事前合意の追加対応 | 費用負担の交渉が紛糾 |
| 関係の帰結 | 継続的な改善関係 | 取引停止・紛争 |
この対立は、検収時の交渉力では解決できません。唯一の予防策は、要件定義の段階で評価指標と合格ラインを数値で合意しておき、未達のときの対応(追加学習の費用負担や期間)まで契約に明記しておくことです。基準を合意しておくことで、検収が「判定作業」に変わり、紛争も「事前に定義された調整」へと置き換わっていくはずです。
AI駆動開発ならEPICs株式会社
「AIで開発を効率化したいが、要件定義の段階で何を決めればいいのかわからない」「過去にAI開発がPoC止まりで終わった経験があり、慎重に進めたい」。そんなお悩みをお持ちであれば、EPICs株式会社にご相談ください。
当社は、AI駆動開発を手がける開発企業です。単なる開発の受託にとどまらず、「そもそもAIで解決すべき課題なのか」という整理の段階からご支援します。
本記事で述べてきたとおり、AI開発の成否は要件定義で決まります。当社では、業務KGIの定義やデータ要件の確定、精度の合格ラインの合意といった、後工程で炎上につながるリスクを、要件の段階で洗い出すプロセスを大切にしています。
AI駆動開発の要件定義についてお悩みの方は、まずはお気軽にご相談ください。貴社の課題に合わせた最適なご提案をいたします。
この記事を書いた人

関連記事
-
 AI駆動開発の本を「目的別」に厳選!全体像・実務・マネジメント・経営の1冊と実践法
-
AI駆動開発の事例4選!成功企業に共通する3つの条件と始め方を解説
-
AI駆動開発とは?従来開発との違い・メリット・リスク・始め方を体系解説
-
AI駆動開発と仕様駆動開発の違いとは?選定基準・使い分け方を実務視点で解説
-
AI駆動開発のベストプラクティス!フェーズ別の実践指針と組織への定着方法
-
AI駆動開発IDEの選び方!Cursor・Copilot・Windsurf・Cline比較と導入の判断軸
-
AI駆動開発研修で生産性を伸ばす!ツール導入で終わらせないための手順
-
Cursorで実践するAI駆動開発【機能の使い分け・一日の流れ・プロジェクト選びの基準】


コメント