AI駆動開発のベストプラクティス!フェーズ別の実践指針と組織への定着方法

AIツールを導入したものの、期待した生産性向上が得られない。生成されたコードの品質に不安が残る。どのツールをどう使い分ければよいか定まらない。AI駆動開発の現場では、こうした課題が繰り返し聞かれます。
その多くは、ツールの性能ではなく、使い方の仕組みに原因があります。生成AIの出力は同じ入力でも変動するため、従来の「仕様を固めれば実装が決まる」という前提が通用しません。各フェーズで何を人間が保証し、何をAIに委ねるかの境界を設計できているかどうかが、成果の再現性を分けることになります。
この記事では、AI駆動開発のベストプラクティスを、要件定義から設計、実装、テスト・レビューまでのフェーズ別に整理します。
あわせて、「なんとなくAI活用」との差が出るポイントや、ベストプラクティスを組織に定着させる仕組み、導入前に整備しておきたい前提条件までをまとめました。属人化を防ぎ、チーム全体で安定した品質を出し続けるための実践的な指針として活用いただけるはずです。
AI駆動開発のベストプラクティス|フェーズ別に整理
AI駆動開発のベストプラクティスは、フェーズ横断の単一原則ではなく、各フェーズで人間が担う「判断」と、AIが担う「生成・探索」の境界線を引く設計に集約されます。
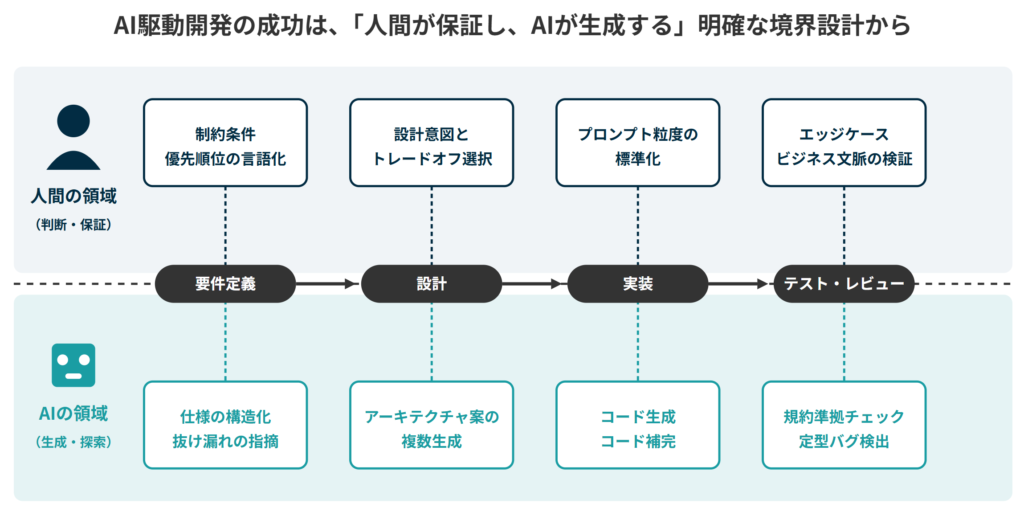
生成AIの出力は同一入力でも変動するため(確率的生成)、従来の「仕様を固めれば実装が決まる」という決定論的な前提は成立しないことに注意が必要です。各フェーズで何を人間が保証し、何をAIに委ねるかを切り分けておくことが、品質の分岐点となるでしょう。
フェーズごとの判断境界を、以下の表に整理します。
| フェーズ | AIが担う領域 | 人間が保証すべき領域 | 品質を左右する変数 |
|---|---|---|---|
| 要件定義 | 仕様の構造化・抜け漏れの指摘 | 制約条件・優先順位の言語化 | 入力情報の粒度 |
| 設計 | アーキテクチャ案の複数生成 | 設計意図とトレードオフの選択 | 評価軸の明示 |
| 実装 | コード生成・補完 | プロンプト粒度の標準化 | 指示テンプレートの統一度 |
| テスト・レビュー | 規約準拠チェック・定型バグ検出 | エッジケース・ビジネス文脈の検証 | 人間レビューの介在設計 |
要件定義フェーズ|曖昧な仕様をAIに渡す前に制約の言語化ができているか
AIへの入力品質が、そのまま出力品質を規定します。たとえば「ログイン機能を作って」という指示では、認証方式や、セッション保持時間、失敗時の挙動といった制約が欠落しており、AIは標準的なパターンで欠落部分を補完してしまいます。この補完が要件と乖離するほど、後工程での手戻りが増えていくことになるでしょう。
要件定義フェーズで言語化したい制約は、具体的には以下の3点です。
- 機能制約
- 非機能制約
- 環境制約
機能制約とは、実現すべき振る舞いと、そこに含めない範囲(スコープ外)を明示しておくことを指します。
非機能制約は、応答時間や同時接続数、データ保持期間など数値で規定する条件のこと。
環境制約は、使用言語やフレームワーク、既存システムとの連携要件を指します。
これらをMarkdown形式の構造化ドキュメントで記述しておくと、AIが解釈する曖昧性が減り、補完による要件乖離を抑えられるようになるはずです。要件定義の段階で曖昧さを排除しきるのではなく、「どの曖昧さを許容し、どの曖昧さを排除するか」を決めておく作業こそが、AI駆動開発における要件定義の実質と言えます。
設計フェーズ|AIの提案をそのまま採用せず設計意図のレビューを挟んでいるか
AIが生成する設計案は、学習データ上で頻出するパターンに収束しがちです。これは「動く設計」ではあっても「そのプロジェクトに最適な設計」とは限りません。AIはトレードオフを認識して提案を出すわけではなく、確率的に妥当な構成を返しているにすぎないためです。
設計フェーズでは、AIに複数案を生成させたうえで、人間が評価軸に照らして選ぶ手順が有効でしょう。この手順を踏むことで、設計判断の根拠が「AIが出したから」ではなく「この評価軸でこの案を選んだ」という形で残るようになります。
設計レビューで確認したい観点を、以下に整理します。
| 観点 | 確認内容 | レビューを省略した場合のリスク |
|---|---|---|
| 拡張性 | 将来の機能追加に耐える構造か | 早期の全面再設計 |
| 結合度 | モジュール間の依存が過剰でないか | 変更の影響範囲が拡大 |
| 既存整合 | 現行システムの設計思想と矛盾しないか | 保守担当者の認知負荷増加 |
設計意図のレビューを挟むことで、AIの提案を「採用・却下した根拠」がチームの資産として蓄積されていくはずです。
実装フェーズ|コード生成の品質を左右するプロンプト粒度の標準化ができているか
同じ実装タスクでも、指示するプロンプトの粒度が開発者ごとに異なれば、生成されるコードの品質や様式もばらついてしまいます。このばらつきは、レビュー負荷の増加とコードベースの一貫性低下を招くことになるでしょう。
プロンプト粒度の標準化とは、つまり「どの情報をどの順序でAIに渡すか」をチームで定型化しておくこと。標準化しておくことで、生成コードの品質が開発者の習熟度に依存しなくなります。
標準化したいプロンプトの構成要素は、具体的には以下の4点です。
- コンテキスト
- 要求仕様
- 制約条件
- 出力形式
コンテキストには、対象ファイルや関連モジュール、既存の命名規則を含めます。要求仕様では、実装する機能と入出力を定義しておきましょう。制約条件には、使用禁止ライブラリやパフォーマンス要件、コーディング規約を記載します。出力形式では、コメントの粒度やテストコードの要否を指定しておくのがおすすめです。
これらをテンプレート化し、コードと同様にバージョン管理しておくことで、プロンプト品質の属人化を防げるようになるはずです。
テスト・レビューフェーズ|AIが見落とすエッジケースを人間がカバーする体制があるか
AIによるレビューは、静的解析とLLMを組み合わせることで、コーディング規約のチェックから文脈を理解した改善提案までを自動化してくれます。一方で、ビジネス固有の文脈理解は不得手であり、AIは「仕様書に書かれていない業務上の例外」を検出できません。
そのため、AIレビューと人間レビューの分業をどう設計するかが、品質保証の前提となってきます。AIは規約準拠と定型的なバグ検出を担い、人間はエッジケースとビジネス文脈を担当する構成が有効でしょう。
役割分担を、以下の表に整理します。
| 検証対象 | AIの担当 | 人間の担当 |
|---|---|---|
| コーディング規約違反 | ◎ 一貫した基準で全件チェック | △ 補助的確認 |
| 定型的なバグ(null参照等) | ◎ 自動検出 | △ 補助的確認 |
| 業務上の例外処理 | × 仕様外は検出不可 | ◎ 業務知識で判断 |
| 境界値・異常系の妥当性 | △ 一般的なケースのみ | ◎ ドメイン固有の境界を判断 |
AIを「人間レビュワーを補助するアシスタント」と位置づけ、ハイブリッドに運用していくことで、レビュー効率と検出網羅性を両立できるようになるはずです。
「なんとなくAI活用」との違いはどこに出るか
「なんとなくAI活用」とベストプラクティスの差は、生産性向上の有無ではなく、成果の再現性に表れます。個人がツールを使って一時的に速度を上げることと、チーム全体で安定した品質を出し続けることは、別の問題と考えたほうがよいでしょう。
AIツールを導入しても期待した生産性向上が得られないケースの多くは、個人の習熟に成果が閉じてしまい、チームの仕組みに転化できていないことに起因します。
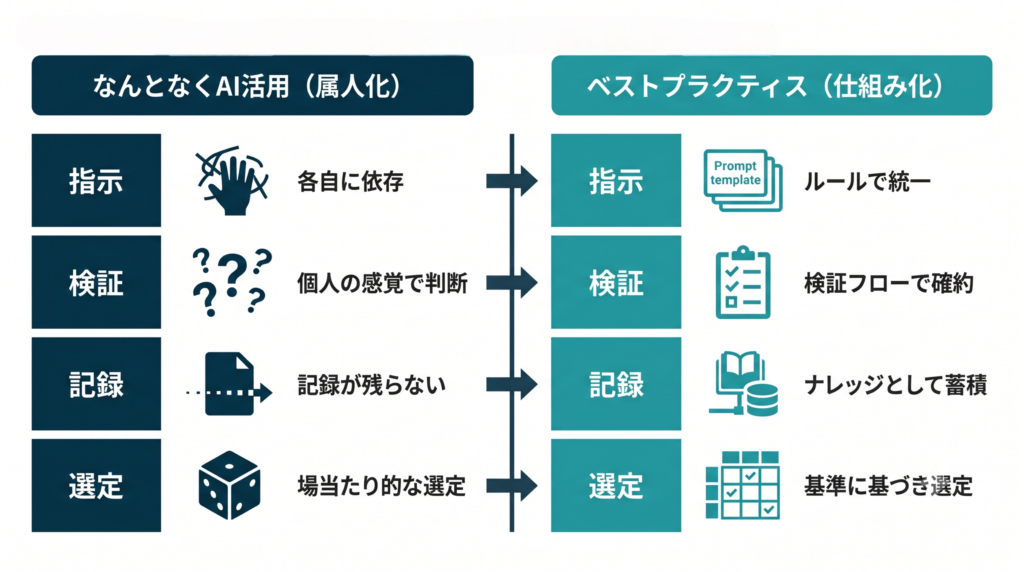
両者の差が表面化するポイントを、以下に整理します。
| 比較軸 | なんとなくAI活用 | ベストプラクティス |
|---|---|---|
| 指示の粒度 | 開発者ごとに異なる | テンプレートで統一 |
| 出力の検証 | 各自の判断に委ねる | ルールとして明文化 |
| 判断の記録 | 残らない | 採用・却下の根拠を蓄積 |
| ツール選定 | 個人の好みで選ぶ | プロジェクト基準で明文化 |
この4軸のいずれかが欠けてしまうと、成果が個人に依存し、退職や異動でその知見が失われていくことになりかねません。
指示の粒度が属人化していないか
同じタスクに対する指示が開発者ごとに異なれば、生成物の品質も様式も分散してしまいます。熟練者は必要なコンテキストを過不足なく渡せる一方、不慣れな開発者は情報を省略しがちで、AIの補完による乖離を招いてしまうことも。この差が、レビュー負荷とコード品質のばらつきとして顕在化していきます。
属人化を解消する手段が、プロンプトのテンプレート化です。テンプレートを用意しておくと、誰が指示しても一定の情報量がAIに渡るようになり、生成品質の下限を保証できるようになるでしょう。属人化しているかどうかは、「特定の担当者が不在のとき、同じ品質の出力を他のメンバーが得られるか」で判断できます。
出力の検証ルールがチーム内で統一されているか
AIの出力をどこまで信頼し、どこから検証するかが各自の判断に委ねられている状態では、検証の網羅性を担保できません。ある開発者は生成コードを精読し、別の開発者はそのままマージするといった差が、品質事故の温床となってしまいます。
検証ルールとして明文化したい項目は、具体的には以下の3点です。
- 必須検証項目
- 検証の深度
- 検証者の指定
必須検証項目とは、セキュリティや認証、データ操作など、AI出力を無検証で採用しない領域を指します。検証の深度では、ロジックの精読が必要な箇所と、動作確認で足りる箇所を区分しておきましょう。検証者の指定については、自己レビューで完結させず、第三者レビューを必須とする範囲を決めておくことが大切です。
ルールを統一しておくことで、検証の抜けが担当者の判断ではなく仕組みで防がれるようになるはずです。
AIの提案を採用・却下した判断根拠を記録しているか
AIの提案を採用・却下した根拠が記録されていなければ、同じ検討が繰り返され、過去の判断が組織知として蓄積されません。「なぜこの設計を選び、AIが提案した別案を却下したのか」という根拠は、後続の保守担当者が設計意図を理解するための手がかりとなってくれます。
記録しておきたい内容は、提案された選択肢と、採用した案、却下した案、そして判断の評価軸です。これらをPull Requestのコメントや設計ドキュメントに残しておくと、判断の再現性を確保できるようになるでしょう。
記録が残っていないと、AIの提案を「動くから採用した」という根拠なき判断に帰着させてしまい、技術的負債の発生源となりかねません。
ツール選定の基準がプロジェクト単位で明文化されているか
AIツールを個人の好みで選定してしまうと、チーム内でツールが乱立し、ナレッジが分散していきます。コード生成AIには、開発支援機能を多角的に備えるタイプと、コード生成に特化したタイプがあり、対応言語や対応IDE、搭載モデル、料金がそれぞれ異なります。
プロジェクトの特性に対して、どの基準でツールを選ぶかを明文化しておく必要があるでしょう。
ツール選定で明文化したい基準を、以下に整理します。
| 選定基準 | 確認内容 |
|---|---|
| 対応言語・フレームワーク | プロジェクトの技術スタックを網羅するか |
| セキュリティ要件 | コードの外部送信範囲が社内ポリシーと整合するか |
| 既存ツール連携 | 使用中のIDE・CI/CDと接続できるか |
| コスト構造 | 利用人数・利用量に対する料金が予算内か |
基準をプロジェクト単位で明文化しておくことで、ツール選定が個人の判断から組織の判断へと移行していくはずです。
AI駆動開発のベストプラクティスを定着させる組織設計
ベストプラクティスを文書化しても、それを更新・運用する組織設計がなければ陳腐化してしまいます。AIモデルは数か月単位で更新され、有効なプロンプトや適切な役割分担も変化していくためです。定着の鍵は、ベストプラクティスを「一度作る成果物」ではなく「継続的に更新するプロセス」として組織に埋め込んでいくことにあると言えます。
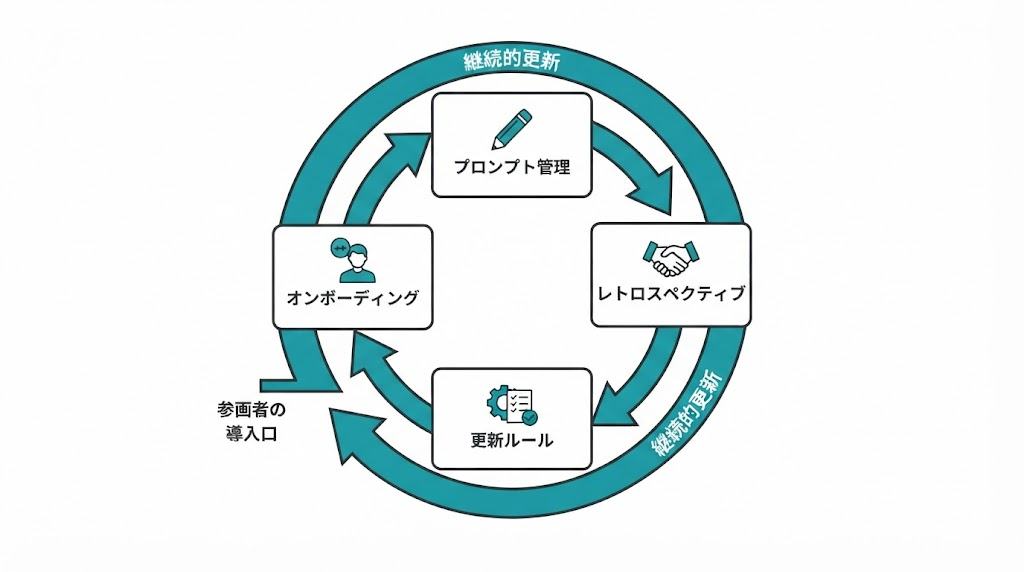
定着に必要な4つの仕組みを、以下に整理します。
| 仕組み | 目的 | 更新の起点 |
|---|---|---|
| プロンプトのバージョン管理 | 指示品質の蓄積と再利用 | コード変更と同期 |
| 週次レトロスペクティブ | 活用知見の共有 | 毎週の定例 |
| 更新権限・頻度の規定 | 陳腐化の防止 | モデル更新・運用変化 |
| オンボーディング資料 | 習得の自走化 | 新規参画時 |
プロンプトのテンプレートをコードと同様にバージョン管理
有効なプロンプトは、コードと同等の資産と考えてよいでしょう。口頭やチャットで共有されたプロンプトは履歴が残らず、改善の経緯も追跡できません。プロンプトテンプレートをリポジトリで管理しておくと、変更履歴や改善理由、適用範囲を記録できるようになります。
バージョン管理によって実現できることは、具体的には以下の3点です。
- 変更の追跡
- 差分の比較
- ロールバック
変更の追跡では、いつ・誰が・なぜプロンプトを変更したかを記録できます。差分の比較を行えば、旧版との違いと、変更による出力品質の変化を検証できるように。ロールバックは、改悪してしまったときに過去の有効な版へ戻す操作を指します。
コードとプロンプトを同じリポジトリで管理しておくと、コード変更とプロンプト変更の対応関係が可視化され、「このコードはどのプロンプトで生成されたか」を追跡できるようになるはずです。
週次レトロスペクティブでAI活用の振り返り
AI活用の知見は、各開発者の手元に分散して蓄積されていきます。これを共有する場がなければ、ある開発者が見つけた有効な手法が、他のメンバーに伝わらないままになってしまいます。週次レトロスペクティブ(定期的な振り返り会)でAI活用の成功・失敗を共有しておくと、知見が個人からチームへと転化していくでしょう。
振り返りで扱いたい論点は、有効だったプロンプトパターンや、AIが誤った出力を返したケース、新たに導入を検討すべきツールなどです。
失敗事例の共有は、同じ誤りの再発を防いでくれますし、成功事例の共有は、有効な手法の横展開を促してくれます。週次という頻度は、モデルの挙動変化や新機能のリリースサイクルに追従できる間隔として機能してくれるはずです。
ベストプラクティスの更新権限と更新頻度をチームで決める
更新権限が曖昧なベストプラクティスは、二つの失敗形態をとりがちです。誰も更新しなければ陳腐化し、全員が無制限に更新すれば一貫性を失ってしまいます。更新権限と更新頻度を事前に規定しておくことで、この両極を回避できるようになるでしょう。
更新ルールで決めておきたい項目を、以下に整理します。
| 規定項目 | 内容 | 規定しない場合の帰結 |
|---|---|---|
| 更新権限者 | 誰が更新を承認するか | 無秩序な変更または放置 |
| 更新頻度 | 定期見直しの間隔 | 古い手法の固定化 |
| 更新トリガー | モデル更新時など見直しの契機 | 環境変化への追従遅延 |
| 周知方法 | 更新をどう全員へ伝えるか | 更新の不徹底 |
更新権限を特定の役割に集約しつつ、更新の提案は全員から受け付ける構成にしておくと、一貫性と現場知見の反映を両立しやすくなります。
AI活用手順を自走習得できるオンボーディング資料
新規参画者がAI活用手順を習得するまでの期間は、既存メンバーの指導コストとして発生してしまいます。オンボーディング資料を整備し、参画者が自走で習得できる状態を作っておくと、この指導コストを削減できるようになるはずです。
オンボーディング資料に含めたい要素は、具体的には以下の3点です。
- 標準プロンプトテンプレート
- 検証ルール
- 失敗事例集
標準プロンプトテンプレートには、すぐに使える指示の雛形と適用例を載せておきます。検証ルールでは、AI出力をどう検証するかの判断基準を示しておきましょう。失敗事例集には、過去にAIが誤った出力を返したケースと、その回避策をまとめておくのがおすすめです。
失敗事例集を含めておくと、新規参画者が同じ誤りを繰り返す確率を下げられます。資料を最新の状態に保つため、前述の更新ルールの対象にオンボーディング資料も含めておくとよいでしょう。
AI駆動開発のベストプラクティス導入前に整備すべき3つの前提条件
ベストプラクティスは、それを機能させる土台の上でしか効果を発揮してくれません。土台が欠けたまま手法だけを導入すると、AIの出力品質が安定せず、「導入したが生産性が上がらない」という結果に至ってしまいます。導入前に整備しておきたい前提条件は、ドキュメントとセキュリティ、開発フロー合意の3点です。
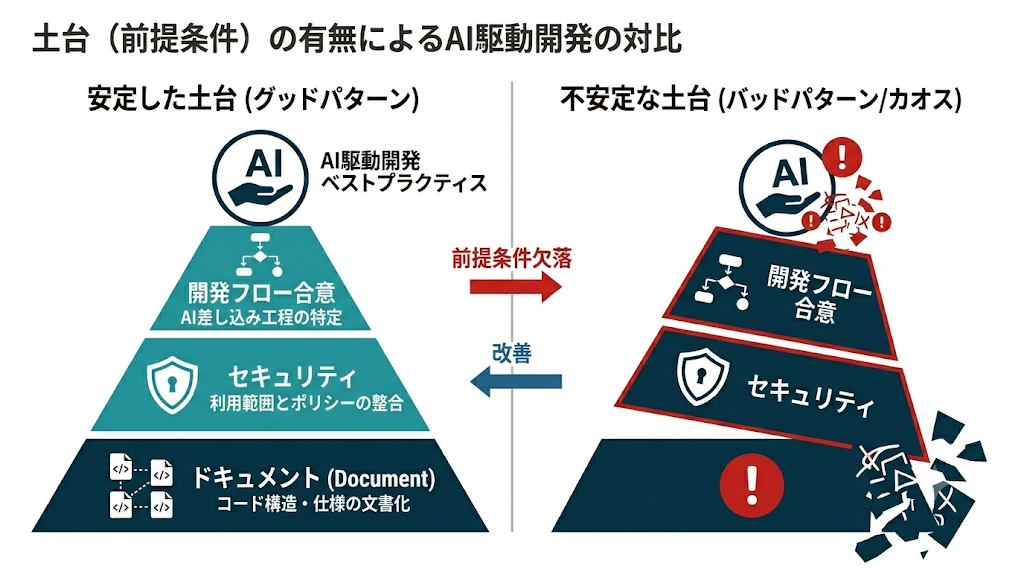
3つの前提条件と、欠落したときの帰結を以下に整理します。
| 前提条件 | 整備内容 | 欠落時の帰結 |
|---|---|---|
| ドキュメント | コードベースの構造・仕様の文書化 | AIが文脈を取得できず出力が乖離 |
| セキュリティ | AIツール利用範囲とポリシーの整合 | 情報漏洩リスクまたは利用の萎縮 |
| 開発フロー合意 | AIを差し込む工程の特定 | 既存プロセスとの摩擦・形骸化 |
コードベースのドキュメント整備状況がAI活用の前提を満たしているか
AIの出力品質は、参照できるコンテキストの質に依存します。ドキュメントが整備されていないコードベースでは、AIはコードの断片からしか文脈を推測できず、設計思想や命名規則を無視した出力を返してしまいます。これが既存コードとの不整合を生み、レビュー負荷を増やしてしまうことに。
ブラックボックス化したレガシーコードに対しては、AIによるドキュメント生成(ソースコードからの仕様・構造の自動抽出)が起点となってくれます。シーケンス図やER図など、人手では作成負荷の高いドキュメントを生成し、AIが参照できるコンテキストを整備しておきましょう。
整備したいドキュメントの優先順位を、以下に整理します。
| 優先度 | ドキュメント種別 | AI活用への寄与 |
|---|---|---|
| 高 | コーディング規約・命名規則 | 生成コードの様式統一 |
| 高 | アーキテクチャ概要 | 設計整合性の維持 |
| 中 | モジュール間の依存関係図 | 変更影響範囲の把握 |
| 中 | 主要APIの仕様 | 連携コードの精度向上 |
社内セキュリティポリシーとAIツールの利用範囲が整合しているか
コード生成AIは、入力されたコードを外部サーバーへ送信する場合があります。送信範囲が社内セキュリティポリシーと整合していなければ、機密コードの漏洩リスクが生じてしまいます。一方で、リスクを懸念して利用を過度に制限してしまうと、AI活用そのものが萎縮してしまうことも。
このトレードオフを解消するには、データの送信範囲とポリシーの境界を事前に突き合わせておく必要があります。確認したい項目は、具体的には以下の3点です。
- データ送信範囲
- 学習利用の有無
- 保存・保持期間
データ送信範囲では、入力コードが外部送信されるか、送信先はどこかを確認します。学習利用の有無については、入力データがモデルの再学習に使われるかどうかをチェックしておきましょう。保存・保持期間では、送信データがどこにどの期間保持されるかを把握しておくことが大切です。
機密度に応じてツールを使い分ける構成も有効でしょう。機密コードにはローカル実行型やエンタープライズ向けの非学習プランを適用し、機密度の低い領域には汎用ツールを許可するようにしておくと、リスクと活用範囲を両立しやすくなります。
既存の開発フローのどこにAIを差し込むか合意が取れているか
AIを既存の開発フローのどこに組み込むかが合意されていなければ、導入は個人の試行に留まり、チーム全体のプロセスとして定着しません。全工程を一度にAI化する移行は失敗率が高く、段階的に組み込んでいくほど成功率が高まっていきます。
差し込み箇所の合意では、どの工程をAIに任せ、どの工程を人間が担うかの境界を明示しておきましょう。導入初期は、効果が測定しやすく、かつリスクの低い工程から着手するのがおすすめです。
差し込み箇所の検討観点を、以下に整理します。
| 工程 | AI差し込みの効果 | 導入の優先度 |
|---|---|---|
| コード補完・生成 | 効果が即座に測定可能 | 高(初期着手向き) |
| テストコード生成 | 網羅性向上・工数削減 | 高 |
| コードレビュー支援 | 規約チェックの自動化 | 中 |
| 要件定義・設計 | 影響が広範で判断負荷が高い | 中(習熟後) |
低リスクな工程から着手し、効果を測定しながら適用範囲を広げていく段階的な導入が、フロー全体への定着につながっていくはずです。
AI駆動開発ならEPICs株式会社
「AIツールを導入したが、期待した生産性向上が得られていない」「生成されたコードの品質に不安がある」。こうした課題をお持ちであれば、EPICs株式会社にご相談ください。
当社は、ノーコードとAIを掛け合わせた開発手法を強みとする開発企業です。AI駆動開発においても、ツールの導入で終わらせず、本記事で示したフェーズ別の判断境界の設計や、プロンプト粒度の標準化、AIと人間のレビュー分業まで含めて、貴社の開発フローに定着する体制づくりをご支援します。
「どの工程にAIを差し込むべきか」「既存のコードベースはAI活用の前提を満たしているか」という導入前の整理段階から伴走し、低リスクな工程から段階的に適用範囲を広げていく進め方をご提案します。
ノーコードによるスピーディーな開発・市場検証と、事業の成長フェーズに応じたスクラッチ開発への移行を柔軟に組み合わせられる点も、当社の特徴です。
さらに、開発で終わらないのが当社の強みです。リリース後のマーケティング支援まで一貫してサポートしており、「作ったけれど使われない」という課題を、企画段階から見据えて解決へと導きます。
予算を有効活用したい中小企業様から、プロダクトを素早く世に出したいスタートアップ様まで、幅広い事業フェーズに対応しております。AI駆動開発をご検討の際はお気軽にお問い合わせください。
この記事を書いた人

関連記事
-
 AI駆動開発の本を「目的別」に厳選!全体像・実務・マネジメント・経営の1冊と実践法
-
AI駆動開発の事例4選!成功企業に共通する3つの条件と始め方を解説
-
AI駆動開発とは?従来開発との違い・メリット・リスク・始め方を体系解説
-
AI駆動開発と仕様駆動開発の違いとは?選定基準・使い分け方を実務視点で解説
-
AI駆動開発の要件定義!炎上を防ぐ5つの定義項目と発注側の役割
-
AI駆動開発IDEの選び方!Cursor・Copilot・Windsurf・Cline比較と導入の判断軸
-
AI駆動開発研修で生産性を伸ばす!ツール導入で終わらせないための手順
-
Cursorで実践するAI駆動開発【機能の使い分け・一日の流れ・プロジェクト選びの基準】


コメント