AI駆動開発IDEの選び方!Cursor・Copilot・Windsurf・Cline比較と導入の判断軸

AI駆動開発IDEの導入を検討すると、まず「Cursor・GitHub Copilot・Windsurf・Clineのどれが正解なのか」という比較に行き着くはずです。ところが2026年現在、各ツールの性能は急速に収束しており、補完精度やエージェント機能だけで優劣をつけるフェーズは終わりつつあります。
選定を本当に左右するのは、ツールのスペックではなく「自社の技術スタック・チーム規模・予算」という制約条件と、「生成コードの責任を誰が担保するか」「コード流出をどう防ぐか」「導入したが使われないをどう避けるか」という運用設計です。
ここを詰めないまま高性能なツールを入れても、検証コストが生産性向上分を上回り、投資が回収できなくなってしまいます。
この記事では、AI駆動開発IDEと従来の補完ツールの違いから、主要4ツールの思想の差、自社に合うツールを導く判断軸、そして導入前に潰しておくべき論点までを整理します。ツール比較の表面的な情報ではなく、AI駆動開発を実務に組み込むための判断基準を持ち帰っていただける内容です。
そもそもAI駆動開発IDEとは何か、従来の補完ツールと何が違うのか
AI駆動開発IDEとは、コードの「入力支援」ではなく「実装の代行」を前提に設計された統合開発環境を指します。従来の補完ツール(IntelliSenseやKiteなど)が「次に書く一語」を予測したのに対し、AI駆動開発IDEは「目的を入力すれば、複数ファイルにまたがる変更を計画・実行・検証する」点で機能の質が異なると言えます。
両者を分ける核心は、AIが扱う単位が「行」から「タスク」へ移ったことにあります。
コード補完とエージェント型開発を分ける境界はどこにあるのか
境界は「AIが自律的にファイルシステムへ書き込み、実行結果を読み取り、次の行動を決めるループを回すかどうか」にあります。
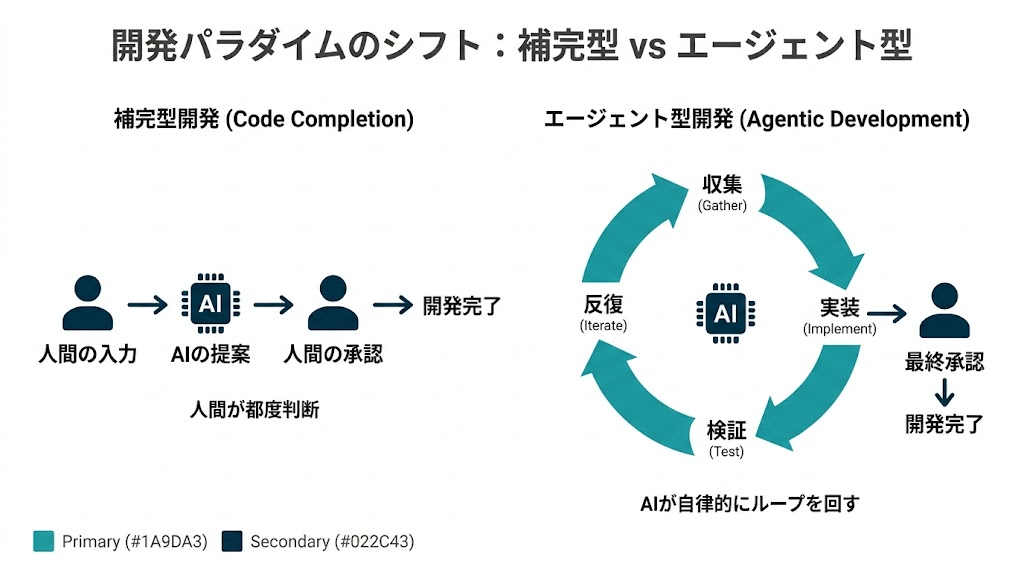
コード補完は、開発者がカーソルを置いた地点に候補を提示するに留まります。判断と適用は人間が行うため、責任の所在も明確です。
一方エージェント型は、AIがファイルを横断して読み込み(コンテキスト収集)、編集案を生成し(実装)、テストやビルドを走らせて(検証)、エラーがあれば自己修正する(反復)という一連のサイクルを自走させます。この「収集→実装→検証→反復」のループを人間の逐次承認なしに回せるかどうかが分水嶺になります。
| 観点 | コード補完型 | エージェント型 |
|---|---|---|
| AIが扱う単位 | 行・関数 | タスク・機能 |
| ファイル横断 | 限定的 | 前提 |
| 実行・検証 | 人間が手動 | AIが自動 |
| 自己修正ループ | なし | あり |
| 責任の所在 | 開発者に明確 | 設計次第で曖昧化 |
この表が示すとおり、エージェント型は生産性と引き換えに「責任の所在」という変数を新たに抱え込むことになります。後述する導入論点の大半は、この一点から派生していくと言えるでしょう。
「IDE」という枠組み自体が問い直されている理由
理由は、AIの動作主体が「エディタ画面の中」から「エディタの外」へ拡張し始めたことにあります。
従来IDEの価値は、エディタ・デバッガ・ターミナルを一画面に統合する点にありました。ところがClaude Codeに代表されるターミナルネイティブ型は、GUI画面を持たず、CLI(コマンドライン)上でエージェントが直接コードベースを操作します。
つまり「人間がコードを編集する場所」というIDEの前提が、「人間がAIに指示を出す場所」へ置き換わりつつあると言えます。CursorやWindsurfがGUIを保持しながらエージェント機能を強化する一方、Claude Codeが画面を捨てた事実は、IDEという概念が二方向へ分岐している証拠と言えるでしょう。
「補完を高度化したIDE」と「IDEを脱したエージェント」の二系統に分かれた、と捉えるのが実態に近いはずです。
AI駆動開発IDEが前提とする新しい開発スタイル
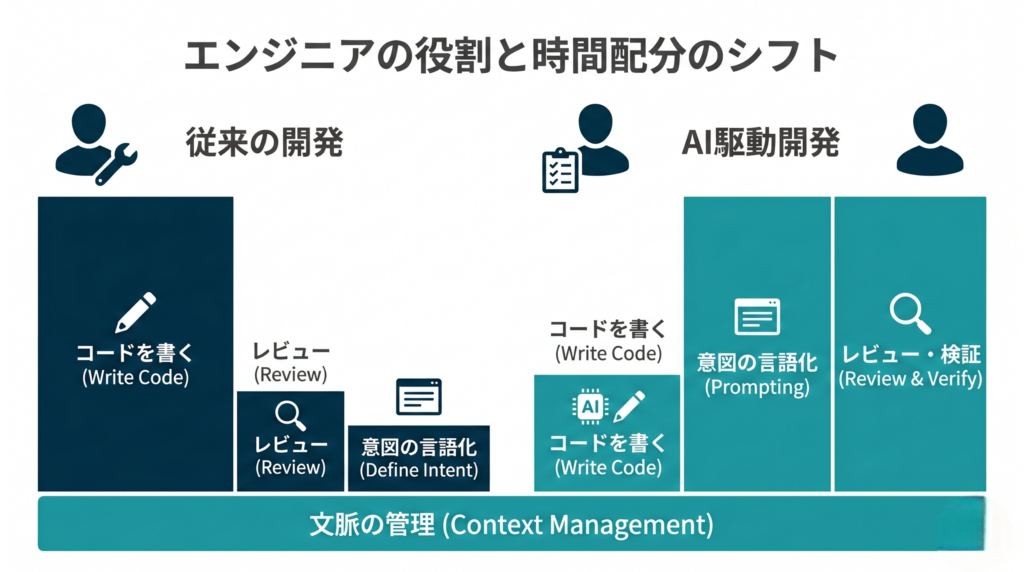
前提となるのは、開発者の役割が「実装者」から「仕様の定義者かつレビュアー」へ移行するスタイルです。
具体的には、以下の3点の転換が起きます。
- 入力の単位が変わる
- 検証の比重が増す
- 文脈の管理が成果を左右する
まず入力の単位が変わります。「どう書くか」をコードで指示するのではなく、「何を実現するか」を自然言語で記述するようになります。AIが手段を選ぶため、開発者は意図の言語化精度を問われるようになるはずです。
次に検証の比重が増していきます。AIが大量のコードを短時間で生成するため、人間の時間は「書く」から「読み・検証する」へ再配分されることに。生成速度がレビュー速度を上回ると、検証されないコードが蓄積するボトルネックが生じてしまいます。
そして文脈の管理が成果を左右します。AIに渡すコンテキスト(既存の設計規約・依存関係・過去の決定)の質が、生成結果の質を直接決めるためです。WindsurfのCascadeがセッションをまたいで文脈を保持する設計を採るのも、この変数を制御するためと言えるでしょう。
この3点が示すのは、AI駆動開発IDEの導入効果が「ツールの性能」ではなく「意図の言語化」と「検証体制」という組織側の準備度に依存する構造です。ツールを入れれば生産性が上がるのではなく、仕様定義とレビューの設計が伴って初めて効果が出てくるはず。次の章以降で、この前提を踏まえた具体的な選定基準に入っていきます。
主要なAI駆動開発IDE(Cursor・Copilot・Windsurf・Cline)の違い
4ツールは「AIにどこまで委ねるか」という委譲度の軸で3タイプに分類できます。同じ「AIコーディング」という言葉で括られながら、思想と最適な使い手が異なる点を整理していきます。
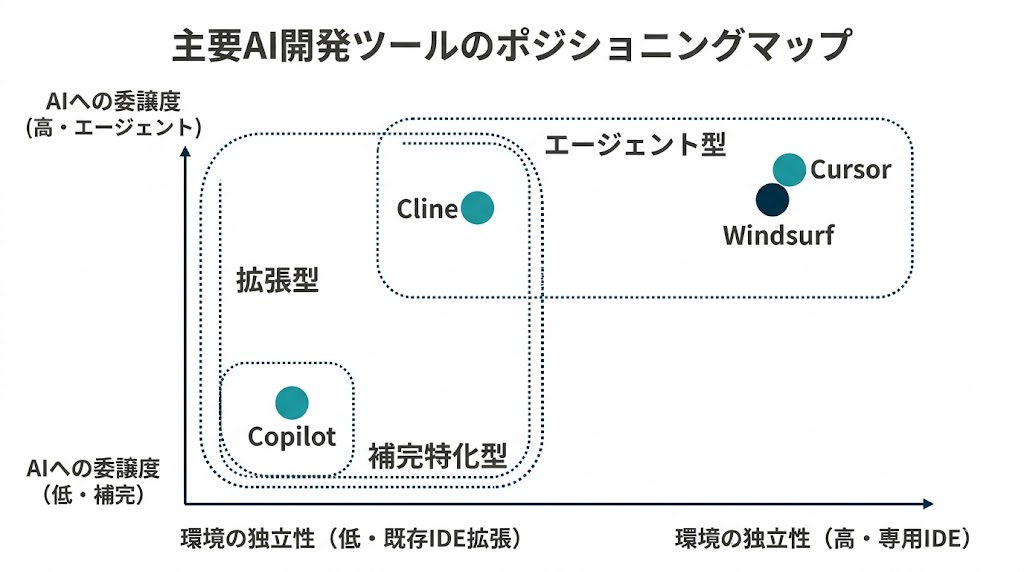
補完特化型・エージェント型・拡張型という3つのタイプ
分類の軸となるのは「AIの動作主体」と「既存環境との関係」の2つです。
具体的には、以下の3タイプに分かれます。
- 補完特化型
- エージェント型
- 拡張型
補完特化型は、開発者の入力を主軸に置き、AIが候補を提示するタイプです。判断は人間が握ります。エージェント型は、AIを主軸に置き、開発者が意図を渡してタスクを委譲するタイプで、専用IDEとして完結します。拡張型は、既存エディタにエージェント機能を後付けするタイプで、環境を変えずに委譲度を上げられるのが特徴です。
| タイプ | 代表ツール | AIの動作主体 | 既存環境 | 適する使い手 |
|---|---|---|---|---|
| 補完特化型 | GitHub Copilot | 人間が主、AIが補助 | VS Code等に統合 | 既存資産を維持したいチーム |
| エージェント型 | Cursor / Windsurf | AIが主、人間が検証 | 専用IDEへ移行 | 委譲を進めたい開発者 |
| 拡張型 | Cline | AIが主、人間が承認 | VS Code拡張 | 環境を変えず試したい現場 |
この分類が重要となるのは、ツール選定が「性能比較」ではなく「自社が委譲をどこまで許容できるか」の判断に帰着するためです。性能は収束しつつあり、差は思想と既存環境との適合性に残っていくと言えるでしょう。
補完特化型:GitHub Copilotが既存資産を持つチームに選ばれる理由
理由は、環境移行のコストをゼロに抑えながら、組織の統制要件を満たせる点にあります。
CopilotはVS CodeやJetBrains、Visual Studioへ拡張として組み込まれ、既存のワークフローを置き換えません。これが「既存資産を持つチーム」に効いてくるのは、移行に伴う再教育コスト・設定資産の喪失・CI連携の再構築を回避できるためです。
加えてGitHub・Azureと統合することで、組織アカウント単位での権限管理や監査ログの取得が標準で備わります。エージェント型が「個人の生産性」を起点に普及したのに対し、Copilotは「組織の統制」を起点に設計された違いがここに表れていると言えます。
ただしトレードオフとして、補完を主軸とする設計上、CursorやWindsurfほど自律的なタスク委譲には踏み込みにくい側面があります。近年はAgent Modeを強化し差は縮まっていますが、思想の出発点が「人間の入力を支援する」点にある事実は、委譲度を最大化したい現場では制約として働くことになるでしょう。
エージェント型:CursorとWindsurfが実現する「任せる」開発
両者は「意図を渡せばAIが実装まで完遂する」点で共通し、文脈の扱い方で思想が分かれます。
Cursorは「速度とコミュニティ」に賭けた設計です。高精度のオートコンプリート、バックグラウンドでタスクを並走させるBackground Agents、AIコーディング最大規模のコミュニティを擁し、毎回コンテキストをリロードする方式で都度の制御性を確保しています。
一方Windsurfは「文脈の永続化」に賭けています。独自システムCascadeがセッションをまたいで設計決定や実装規約を記憶し続けるため、「昨日合意したアーキテクチャを今日の作業に反映する」連続性が成立するように。
両者の現在地を整理します。
| 観点 | Cursor | Windsurf |
|---|---|---|
| 思想 | 速度・制御性 | 文脈の永続化 |
| 文脈管理 | 都度リロード | Cascadeが記憶を維持 |
| 対応環境 | VS Codeベース | 40以上のIDE向けプラグイン |
| 独自モデル | 各種LLMを選択 | SWE-1(エンジニアリング特化) |
| 月額 | 約20ドル | 約15〜20ドル |
選定の分岐点となるのは、開発が「単発タスクの高速処理」中心か、「長期プロジェクトの文脈継続」中心かという点です。前者ならCursor、後者ならWindsurfが構造的に噛み合ってくるはずです。
拡張型:Clineが既存エディタ環境にもたらす柔軟性
Clineの価値は、VS Code拡張として動きながら、使用するLLMとAPIを開発者が自由に選べる点にあります。
CursorやWindsurfがツール側でモデルを抱えるのに対し、Clineはオープンソースであり、バックエンドのAPIを開発者が指定できます。
これが柔軟性を生むのは、モデルの選択権とコストの制御権が利用者側に残るためです。タスクに応じて高性能モデルと低コストモデルを使い分けられ、料金も従量課金で実コストに連動していきます。反面、API設定やモデル選定を自前で行う前提があるため、初期構築の手間という変数を負うことになります。
実務上の最適解は、ツールの排他選択ではなく組み合わせにあると言えるでしょう。日常の開発にはCursorまたはWindsurfを使い、特定の大規模リファクタや自由なモデル選択が要る局面でClineを呼び出す。
この使い分けが、委譲度とコスト統制を両立させる現実的な構成になるはずです。次の章では、この4ツールから自社の正解を導く判断軸を扱っていきます。
自社の開発チームにとってどれが正解か、判断軸をどう持つか
正解となるのは「最も高性能なツール」ではなく「自社の制約条件に最も適合するツール」です。性能が収束した2026年において、選定を決めるのは技術スタック・チーム規模・予算という組織側の変数だと言えます。
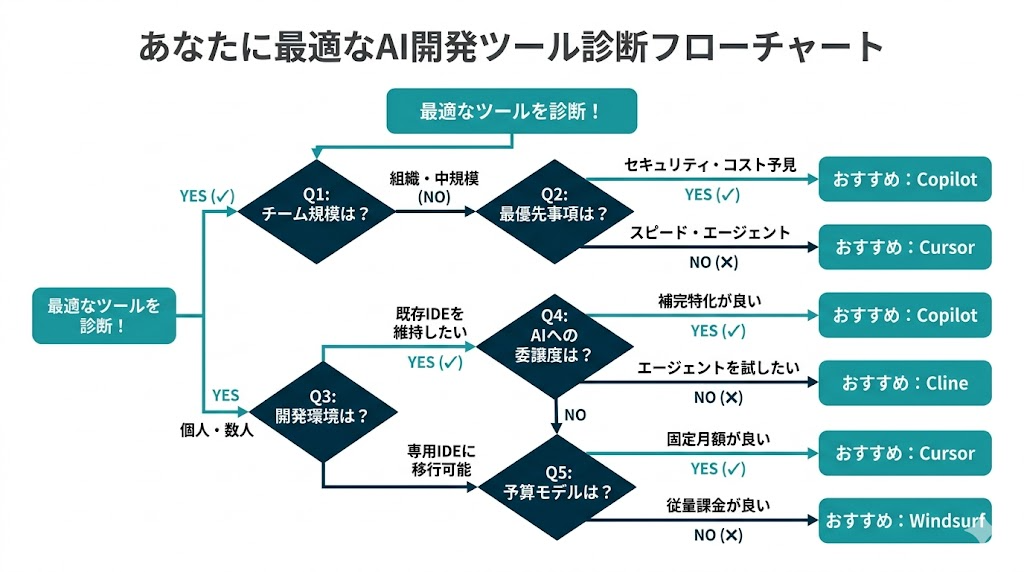
技術スタック・チーム規模・予算という3つの判断軸
選定を誤らせる最大の要因は、軸を持たずに「評判」で選んでしまうことです。判断は次の3軸で分解できます。
具体的には、以下の3点です。
- 技術スタック
- チーム規模
- 予算
技術スタックは、既存エディタ(VS Code / JetBrains等)とCI/CD・リポジトリ管理(GitHub / GitLab)との連携要件を指します。移行コストとロックインリスクを左右する軸です。
チーム規模は、個人か、数名か、組織全体かという観点です。権限管理・監査・ライセンス調達の必要性が規模で変わってきます。予算は、固定費(席数課金)か変動費(従量課金)かという軸です。利用量の予測可能性が、適する課金モデルを決めていきます。
| 判断軸 | 重視する条件 | 適合しやすいツール |
|---|---|---|
| 技術スタック | GitHub中心・統制重視 | GitHub Copilot |
| 技術スタック | 多様なIDE・文脈継続 | Windsurf |
| チーム規模 | 組織・監査要件あり | GitHub Copilot |
| チーム規模 | 個人〜少人数 | Cursor |
| 予算 | 固定費で予算化したい | Copilot / Cursor(席数課金) |
| 予算 | 実コスト連動・モデル選択 | Cline(従量課金) |
この表が示すのは、3軸の重みづけが組織ごとに異なるため、汎用的な「おすすめ」は成立しないという点です。自社でどの軸が最も重いかを先に確定させておくことが、選定の出発点になると言えるでしょう。
個人開発とチーム開発で変わる選定基準
選定基準が変わるのは、評価対象が「個人の生産性」から「組織の統制可能性」へ移るためです。
個人開発では、生産性とコストが評価軸の中心となります。誰がコードを承認するか、誰がライセンスを管理するかといった論点が存在せず、純粋に「速く・安く書けるか」でCursorやClineが噛み合ってきます。一方チーム開発では、生産性に加えて統制が変数として浮上してくることになります。
| 観点 | 個人開発 | チーム開発 |
|---|---|---|
| 評価軸 | 生産性・コスト | 統制・再現性・監査 |
| 権限管理 | 不要 | 必須 |
| コード規約の統一 | 任意 | エージェント設定で強制 |
| 課金単位 | 個人 | 席数・組織契約 |
| 重視点 | 速度 | レビュー体制との整合 |
チーム開発で見落とされやすいのが「再現性」です。個々の開発者が異なるツール・異なるモデルを使うと、生成コードの品質と規約遵守度がばらついてしまいます。組織として規約ファイル(Cursor RulesやCascadeの設定)を共有し、全員が同一の制約下で生成する体制を組めるかどうかが、チーム導入の成否を分けることになるでしょう。
レガシーコードを多く抱える現場での優先順位
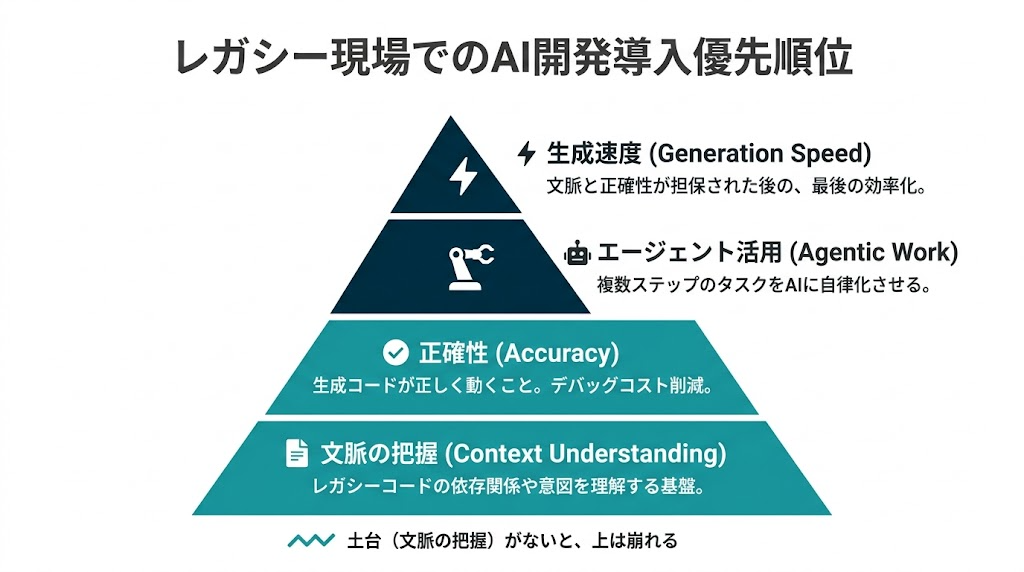
優先すべきは「生成速度」ではなく「既存コードベース全体を読み込む文脈把握能力」です。
理由は、レガシー現場の課題が「新規コードを速く書くこと」ではなく「既存の依存関係・暗黙の規約・歴史的経緯を壊さずに変更すること」にあるためです。文脈を把握しないエージェントは、既存パターンを無視した生成を行い、かえって技術的負債を増やしてしまいます。したがって優先順位は次のように整理できます。
| 優先順位 | 要件 | 理由 |
|---|---|---|
| 第1 | 大規模コンテキストの把握 | 既存の依存・規約を壊さないため |
| 第2 | 文脈の永続化 | 過去の設計決定を変更へ反映するため |
| 第3 | 段階的な承認制御 | 自動変更の暴走を防ぐため |
| 第4 | 生成速度 | 上記が満たされて初めて意味を持つ |
具体的には、コードベース全体を把握できる大容量コンテキストを持つツール(Claude Code的なアプローチや、文脈を記憶するWindsurfのCascade)が、レガシー現場では速度特化型より優位に立つと言えるでしょう。
レガシー対応で生成速度を第一に選んでしまうと、検証コストが生産性向上分を上回る逆転が起きてしまいます。この因果を踏まえた優先順位づけが要点となります。次の章では、選定後に潰すべき導入前の論点を扱っていきます。
意思決定者が見落としがちな、導入前に潰すべき論点
導入の失敗は、ツール選定の誤りより「運用設計の欠落」から生じます。生産性の数値に注目が集まる一方、責任・セキュリティ・定着という3つの論点が後回しにされ、導入後に表面化する構造があると言えます。
生成コードの品質と責任を誰が担保するか
担保の所在を契約・体制として明文化しない限り、AIが書いたコードの瑕疵は宙に浮いてしまいます。
問題の核心となるのは、エージェント型が「人間の逐次承認なし」にコードを生成する設計にある点です。補完型では開発者が一語ずつ判断するため責任は明確でしたが、エージェント型では誰がそのコードを承認したのかが曖昧化していきます。
この曖昧さを放置すると、障害発生時に「AIが生成した」を理由に責任が分散し、再発防止のループが回らなくなってしまいます。
潰すべき論点は次の3点です。
| 論点 | 放置した場合のリスク | 設計すべき対応 |
|---|---|---|
| 承認の主体 | 障害時に責任が分散 | 生成コードもレビュー必須・承認者を記録 |
| 品質基準 | 規約逸脱コードの混入 | テスト通過とレビュー承認を統合の前提に |
| ライセンス | 生成物の権利・出自が不明 | 出力の取り扱い規約を組織で明文化 |
要点となるのは、AIを「執筆者」ではなく「ドラフト作成者」と位置づけ、最終責任は人間のレビュアーが負う体制を契約・運用の両面で固定しておくことです。生成速度がレビュー速度を上回る前提で、レビューを省略可能な工程と見なした瞬間に品質統制は崩れてしまうでしょう。
コード流出・セキュリティ懸念への備え方
備えの中心となるのは「コードがどこへ送信され、どこに保持されるか」をツール選定の段階で確定させておくことです。
懸念の本質は、AIコーディングがコードを外部のモデルへ送信して処理する構造にある点です。送信先・学習利用の有無・保持期間が不明なまま導入すると、自社の知的財産が外部に流出するリスクを負うことになります。備えは次の軸で分解できます。
具体的には、以下の3点です。
- 送信先の管理
- 学習利用の遮断
- 保持と監査
送信先の管理とは、コードがどのモデル提供者へ送られるかという観点です。自社で送信先を選べるか(Clineのようにモデルを指定できるか)、ツール側が固定するかで扱いが変わってきます。
学習利用の遮断は、送信したコードがモデルの再学習に使われない契約(オプトアウトやエンタープライズ契約)を結べるかどうかという点です。保持と監査は、プロンプトと生成物のログがどこに保持され、組織が監査できるかという観点になります。
| 要件 | 個人向けプラン | エンタープライズ向け |
|---|---|---|
| 学習利用の遮断 | 限定的 | 契約で明示可能 |
| 送信先の制御 | ツール依存 | 専用環境・指定可能 |
| 監査ログ | 取得困難 | 標準提供 |
機微なコードを扱う組織ほど、無料・個人向けプランの利用を規約で禁止しておき、学習利用を遮断できる組織契約へ統一しておく設計が必要になるでしょう。流出リスクは性能の問題ではなく契約と設定の問題であり、ツール導入時に必ず潰しておくべき論点だと言えます。
「導入したが使われない」を防ぐ運用設計
定着しない原因は、ツールの性能不足ではなく「使い方の標準化と検証文化の欠落」にあります。
導入が失敗する典型となるのが、ライセンスを配布して終わる運用です。開発者が各自の流儀で使うと、生成品質はばらつき、効果が可視化されず、やがて利用が形骸化してしまいます。定着を生むのは、標準化→可視化→改善のループを組織に埋め込んでいくことだと言えるでしょう。
| 失敗パターン | 原因 | 運用設計上の対策 |
|---|---|---|
| 各自バラバラの使い方 | 規約・指示の標準が不在 | Rules・設定ファイルを組織で共有 |
| 効果が分からない | 計測指標が未設定 | レビュー時間・手戻り率を導入前後で計測 |
| レビューが追いつかない | 生成量に検証が不足 | レビュー基準と分担を事前設計 |
| 一部の人しか使わない | 成功事例が共有されない | 効果の出た使い方を横展開 |
要点となるのは、AI駆動開発IDEの効果が「ツールの導入」ではなく「意図の言語化規約・検証体制・効果計測」という運用設計の有無で決まる構造です。第1の章で述べた「効果は組織側の準備度に依存する」という前提が、ここで運用論として帰結してきます。
ツールは前提条件にすぎず、定着を設計する主体は組織側にあるという認識が、導入を投資回収へつなげる分岐点になるはずです。
AI駆動開発ならEPICs株式会社
「AI駆動開発IDEを導入したいが、どのツールが自社に合うのか判断できない」「個人での試用は進んだが、チーム全体の運用設計まで描けていない」。そうしたお悩みをお持ちであれば、EPICs株式会社にご相談ください。
当社は、AI駆動開発を実務に組み込んできた開発企業です。本記事で整理したとおり、ツールの性能は収束しつつあり、導入効果を決めるのは「技術スタック・チーム規模・予算」という自社の制約条件と、「責任分担・セキュリティ・定着」という運用設計にあります。
貴社の既存のコードベースや開発フロー、レビュー体制の実態をヒアリングしたうえで、生成コードの品質を誰が担保するか、コード流出をどう防ぐか、現場に定着させる運用をどう組むかまで含めた導入プランをご提案します。ツールを入れて終わりではなく、標準化・可視化・改善のループを組織に根づかせるところまでを設計の対象としているのが特徴です。
レガシーコードを多く抱える現場での優先順位づけ、チーム全体での規約共有、エンタープライズ契約によるセキュリティ要件の充足など、本記事で挙げた論点を一つずつ潰しながら、AI駆動開発を投資回収へつなげる体制づくりをサポートします。
AI駆動開発の導入や運用設計についてお悩みの方は、まずはお気軽にご相談ください。貴社の開発体制に合わせた最適なご提案をいたします。


コメント