Cursorで実践するAI駆動開発【機能の使い分け・一日の流れ・プロジェクト選びの基準】

AI駆動開発という言葉が広まるにつれ、その入り口としてCursorを検討する企業が増えています。ただし、Cursorを導入すれば開発が自動化されるわけではありません。Cursorの価値は、Chat・Composer・Agentという3層の機能を、人間が握る判断とAIへ委譲する作業の境界を設計したうえで使い分けることで初めて生まれます。
この記事では、AI駆動開発とCursorがどう結びつくのか、3層の機能がどのように連動するのか、そして一日の開発フローの中でどう使い分けるのかを、実務の工程に沿って整理します。
あわせて、導入で失敗しないためのプロジェクト選びの基準と、整えておくべき前提条件についてもお伝えします。
AI駆動開発とCursorはどう結びつくのか?「書くAI」から「考えるAI」へ
AI駆動開発とは、コードを書く工程の一部をAIに任せる開発手法ではなく、要件の解釈・設計・実装・検証という工程の連なりそのものを、人間とAIが役割を分担しながら進める開発体制を指します。
Cursorは、この体制を1つのエディタ上で完結させるために設計されたツールです。両者が結びつく理由は、Cursorが「コードを書く支援」ではなく「開発工程を引き受ける主体」として設計され直した点にあると言えるでしょう。
そもそもAI駆動開発とは何を指す言葉なのか
AI駆動開発(AI-Driven Development)は、人間が判断・指示を担い、AIが生成・検証・修正を担う分業構造を前提とした開発手法を指します。従来の開発では、人間が仕様を読み、設計し、コードを書き、テストを書くという全工程を担っていました。AI駆動開発では、この工程を「人間が決めること」と「AIに任せること」に分解していきます。
分解の軸となるのは、判断の不確実性です。要件の優先順位やアーキテクチャの選択といった、誤れば手戻りコストが大きい判断は人間が握ります。
一方で、決まった仕様をコードへ変換する作業や、定型的なテストの記述は、AIへ移譲していくことになります。AI駆動開発の本質は「AIにコードを書かせること」ではなく、「人間の判断時間を、移譲可能な作業から切り離すこと」にあると言えるでしょう。
コード補完と「AI駆動」は何が違うのか
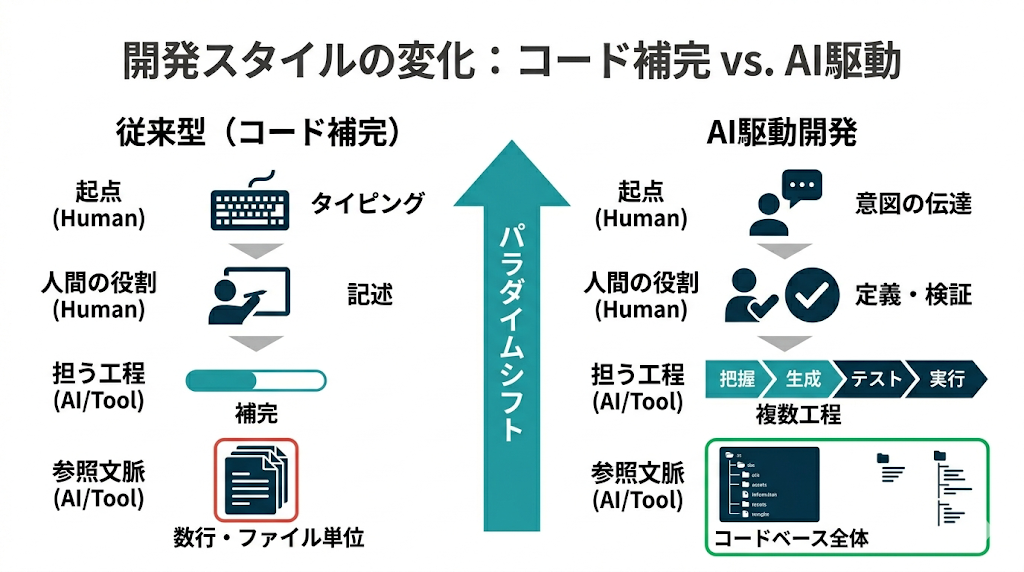
両者の違いは、AIが参照する文脈の範囲と、AIが担う工程の数にあります。
| 観点 | コード補完(従来型) | AI駆動開発 |
|---|---|---|
| 参照する文脈 | 編集中のファイル・直前の数行 | コードベース全体・関連ファイル |
| 担う工程 | コードの記述(1工程) | 設計補助・実装・検証・修正(複数工程) |
| 起点 | 人間がタイプした文字 | 人間が言語で伝えた意図 |
| 人間の役割 | コードを書きながら候補を選ぶ | 意図を伝え、結果をレビューする |
コード補完は、人間が書く行為を高速化する技術です。人間がコードを書く前提は変わりません。一方でAI駆動開発は、人間がコードを書く前提そのものを外し、「意図を伝える」起点から工程を組み直していきます。この差が、開発者の作業時間の配分を変えていくことになるはずです。
Cursorが「考えるAI」へと一歩踏み込んだ点
Cursorが補完ツールと一線を画すのは、コードベース全体を文脈として読み込み、複数工程を1つのタスクとして引き受ける設計に転換した点です。
2026年4月にリリースされたCursor 3.0では、UIが根本から再設計され、複数のAIエージェントを並列実行・管理する「Agents Window」が中心に据えられました。これは「AIがコードを書くことを前提」にした再設計であり、補完機能の延長ではないと言えるでしょう。
「考えるAI」という表現が示すのは、AIが思考能力を持ったという意味ではなく、人間が与える文脈の粒度が「行」から「意図」へ移ったという意味です。
つまり、人間が「この関数をこう直す」と指示する段階から、「この機能を追加したい」と意図を伝える段階へ移行したということ。Cursorは、この意図を受けてどのファイルを触るべきかを自ら特定し、変更案を提示してくれます。
開発者に求められる役割の移り変わり
役割の移り変わりは、3つの段階で整理できます。
| 段階 | 開発者の主作業 | AIの担当範囲 |
|---|---|---|
| 補完期 | コードを書く | 次の数行を提案 |
| 対話期 | AIに依頼し、出力を取捨選択 | ファイル単位の生成・修正 |
| 委譲期 | 意図を定義し、結果を検証 | 複数ファイル・複数工程の自律実行 |
委譲期において、開発者の価値は「速くコードを書けること」から「AIの出力が要件を満たすかを判断できること」へ移っていきます。ここにトレードオフが生じます。
AIへの委譲範囲を広げるほど開発速度は上がりますが、生成物の妥当性を検証する責任は人間に残り続けるからです。検証能力を伴わない委譲は、誤りを高速に量産する結果を招きかねません。AI駆動開発の導入とは、この検証体制をどう設計するかという問いと不可分なものとなるでしょう。
Cursorが「ただのAIエディタ」で終わらない理由
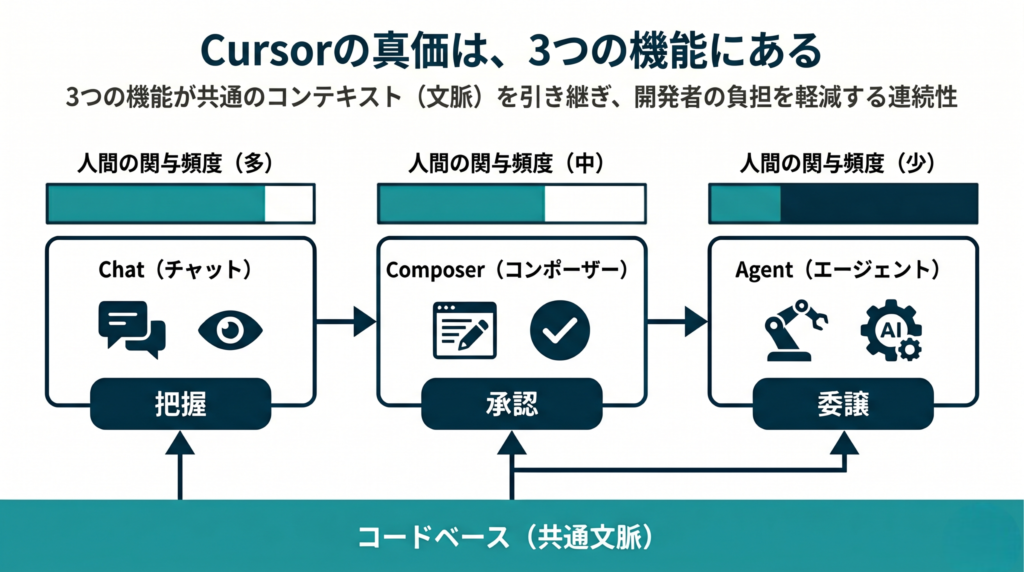
Cursorがエディタの枠を超える理由は、機能が単体で完結せず、Chat・Composer・Agentの3層が異なる工程を担い、それらが連鎖して1つの開発フローを構成する点にあります。
1つずつ見た機能はコード補完ツールにも存在しますが、3層が文脈を共有しながら連動する構造こそが、Cursorをエディタからエージェント実行基盤へと変えていると言えるでしょう。
コードベース全体を踏まえて応答するChat機能
Chat機能は、編集中のファイルだけでなく、@codebaseという指定でプロジェクト全体を文脈に含めて応答してくれます。つまり、ある関数の挙動を尋ねたとき、その関数が他のどのファイルから呼ばれ、どう依存しているかを踏まえた回答が返ってくるということ。
この設計が解決してくれるのは、文脈断絶の問題です。汎用チャットツールにコードを貼り付けて質問する場合、人間が関連ファイルを手作業で集めて貼り付ける必要があり、貼り忘れた依存関係は回答に反映されません。
一方でChat機能は、依存関係の探索をAIへ移譲することで、人間が文脈を組み立てる作業を省いてくれます。結果として、コードベースが大きいほど、Chat機能と汎用ツールの精度差は開いていくはずです。
複数ファイルをまたいで編集するComposer
Composerは、自然言語で記述した変更内容を、コードベース全体にまたがって適用してくれる機能です。1つの機能追加が複数ファイルへの変更を要する場合、従来はファイルを1つずつ開いて手で直していました。Composerなら、影響範囲を自ら特定し、複数ファイルへの変更案をまとめて提示してくれます。
ここで把握しておきたい変数が、リクエスト消費です。Composerの各操作は、影響を受けるファイル数に比例してプレミアムリクエストを消費していきます。
変更範囲が広いほど消費は増えていき、無料枠では数日で割り当てを使い切ってしまう場合もあるでしょう。Composerの価値は変更範囲の広さに比例しますが、コストも同じ軸で増えていくという構造を理解したうえで使うことが大切です。
タスクを受けて自律的に動くAgentモード
Agentモードは、複数ファイルへの変更・ターミナルコマンドの実行・エラーの検出と修正を、人間の都度の指示なしに繰り返してくれる機能です。「テストを通るまで修正して」という指示に対し、AIが変更・実行・エラー確認・再修正のループを自律的に回してくれます。
| 機能 | 人間の関与頻度 | 適した作業 |
|---|---|---|
| Chat | 1問1答ごと | 仕様の確認・調査 |
| Composer | 変更案の承認ごと | 機能追加・横断的な修正 |
| Agent | タスク投入時とレビュー時のみ | テスト・リファクタリング・反復作業 |
Agentモードのリクエスト消費は、1つのマルチステップタスクで5〜10リクエストに達する場合もあります。自律性が高い分、人間が消費を制御しづらく、何を任せ何を任せないかの線引きが運用上の判断点となってくるでしょう。
三つの機能を組み合わせたときに生まれる相乗効果
3機能が連動する価値は、工程ごとに最適な関与頻度を切り替えられる点にあります。具体的には、以下の3段階で文脈が引き継がれていきます。
まずChatで仕様や既存コードの構造を把握します。次に、把握した内容をComposerへ渡し、変更案を生成して承認します。そして、検証や反復作業をAgentへ委譲していくという流れです。
この流れで重要になるのは、3機能が同一のコードベース文脈を共有している点です。Chatで得た理解を別ツールへ手作業で移し替える必要がなく、文脈の引き継ぎコストがゼロに近づいていきます。
単機能で見れば、Chatは他のチャットツール、Agentは他の自律エージェントに置き換えることもできるでしょう。しかし置き換えられないのは、3層が文脈を共有したまま関与頻度を切り替えられる連続性です。Cursorがエディタで終わらない理由は、個々の機能の性能ではなく、この工程間の文脈連続性にあると言えます。
Cursorを軸にしたAI駆動開発の一日の流れ
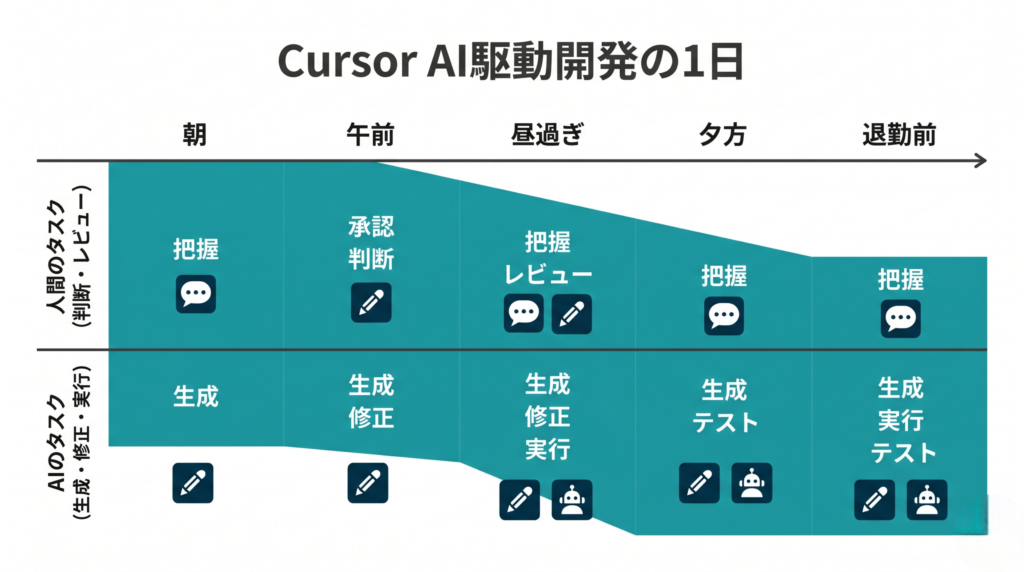
一日の流れを工程順に見ていくことで、Chat・Composer・Agentの3層をどの時間帯にどう使い分けるかが具体化していきます。
ここで示すのは理想的な一日ではなく、各時間帯で人間が握るべき判断と、AIへ移譲できる作業の境界線です。時間配分の前提となるのは、人間の判断時間を午前に集中させ、午後にかけて委譲範囲を広げていく構造にあります。
朝:今日のタスクをCursorに整理してもらうところから始める
朝の起点となるのは、Chat機能を使ったタスクの構造化です。「このissueに対応するには、どのファイルを触る必要があるか」とChatへ問うことで、コードベース全体から影響範囲を洗い出せます。これにより、着手前に変更箇所の見当をつけられるようになるでしょう。
ここで人間が握る判断は、タスクの優先順位と分解の粒度です。AIは影響範囲を列挙してくれますが、どれを今日やるか、どこで区切るかは人間が決めていきます。
朝にこの構造化を済ませておく理由は、後の工程でAIへ委譲する単位を、人間が把握できるサイズに切り分けておくためです。委譲単位が曖昧なまま午後を迎えてしまうと、AgentやComposerの出力を検証できなくなってしまいます。
午前:要件を伝え、実装の叩き台を一気に作る
午前は、Composerで実装の叩き台を生成していきます。朝に切り分けたタスク単位ごとに、要件を自然言語で伝え、複数ファイルにまたがる変更案を一括で受け取っていく流れです。
この時間帯にComposerを使う理由は、叩き台の生成が「人間の判断を多く要するが、定型化はできない」工程だからです。Plan Mode(Shift+Tab)で計画を立ててから実行する手順を挟んでおくと、AIが何をどの順で変更するかを事前に確認でき、意図とのズレを実装前に修正できるようになります。
叩き台の精度は、午前に投じる要件記述の具体度に比例していきます。曖昧な要件は曖昧な叩き台を生み、午後の修正工数へ転嫁されてしまうでしょう。
昼過ぎ:Composerで複数ファイルをまたいだ修正をかける
昼過ぎは、午前に生成した叩き台に対し、Composerで横断的な修正を加えていきます。命名規則の統一、共通処理の切り出し、インターフェースの変更といった、複数ファイルへ同時に波及する修正がこの時間帯の対象となります。
| 時間帯 | 主に使う機能 | 作業の性質 |
|---|---|---|
| 午前 | Composer(Plan Mode) | 新規生成・判断密度が高い |
| 昼過ぎ | Composer(修正適用) | 横断修正・承認の反復 |
昼過ぎにこの作業を置く理由は、叩き台が一通り揃った段階でなければ、横断修正の影響範囲が確定しないためです。修正のたびにComposerは影響ファイル数に応じたリクエストを消費していくため、修正をまとめて一度にかける運用が、消費効率の面でも理にかなっていると言えるでしょう。
夕方:Agentモードにテストやリファクタリングを任せる
夕方は、Agentモードへ検証と整形を委譲していきます。テストの記述と実行、命名やコード構造のリファクタリングは、変更・実行・エラー確認・再修正のループを要する反復作業であり、Agentの自律実行に適しています。
夕方にAgentを使う理由は2つあります。1つは、実装が固まった後でなければテスト対象が定まらないこと。もう1つは、Agentが長尺タスクを処理する間、人間は別の作業へ移れることです。
長時間かかるタスクはクラウドAgentへオフロードでき、ローカルの作業を止めずに済みます。ここで人間が握るのは、テストが検証すべき要件の定義です。何をもって正しいとするかをAgentは判断できないため、合否基準は人間が与えていく必要があります。
退勤前:変更内容をレビューし、明日への引き継ぎをまとめる
退勤前の工程となるのは、AIが生成・修正・検証した全変更を人間がレビューする段階です。AI駆動開発において、この工程は省略できません。委譲範囲を広げるほど、人間が検証する責任は重くなるという原則が、ここで効いてくるからです。
レビューで確認するのは、コードが動くかではなく、要件を満たしているかです。動作の確認はAgentが済ませている前提のため、人間は「この実装が、朝に定義した意図と一致するか」を判断していきます。
一致しない差分は、明日のタスクとしてChatへ記録しておき、翌朝の構造化工程の入力としていきます。この引き継ぎが、一日のフローを翌日へ接続し、判断単位の連続性を保ってくれるはずです。
Cursor導入で失敗しないプロジェクト選びの基準
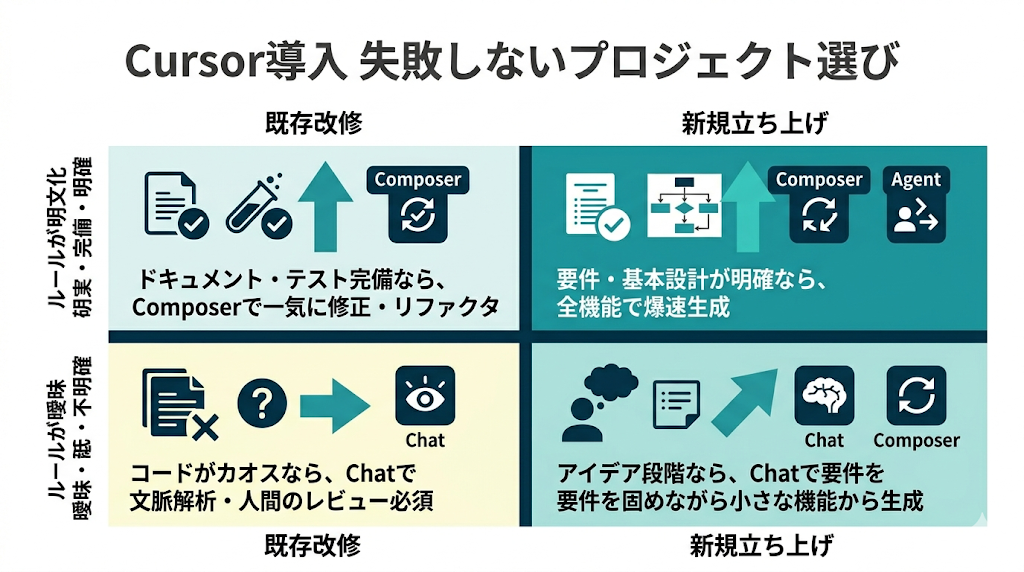
Cursorの導入効果は、どのプロジェクトに適用するかで大きく変わってきます。失敗の多くはツールの性能不足ではなく、適性の低いプロジェクトへ適用してしまった結果として生じます。選定の軸となるのは、新規か既存か、規模・言語・フレームワークとの相性、そして導入前の前提条件の3点です。
新規立ち上げと既存改修での向き不向き
新規立ち上げと既存改修では、Cursorが効く局面が異なってきます。
| 観点 | 新規立ち上げ | 既存改修 |
|---|---|---|
| AIの文脈把握 | 制約が少なく生成しやすい | 既存の設計思想を読み取る必要がある |
| 効果が出る工程 | 叩き台の高速生成 | 影響範囲の特定・横断修正 |
| 主なリスク | 設計の一貫性が崩れやすい | 既存仕様の誤読による回帰 |
| 適した機能 | Composer | Chat+Composer |
新規立ち上げでは、Composerによる叩き台生成が速度を生んでくれます。一方で、AIは過去の判断を引き継がないため、設計の一貫性は人間が監督しないと崩れていきます。
既存改修では、@codebaseを起点としたChatの影響範囲特定が効いてきます。ただし、既存コードに設計意図が明文化されていない場合、AIはその意図を誤読し、既存仕様を壊す変更を提示してしまうこともあるでしょう。
どちらが向くかは一概に決まるものではなく、設計意図がどれだけ言語化されているかで適性が変わってきます。
規模・言語・フレームワークとの相性
相性を左右する変数となるのは、コードベースの規模・言語の普及度・フレームワークの規約性の3つです。
規模については、コードベースが大きいほどChatの影響範囲特定が価値を生む一方、Composerのリクエスト消費も増えていきます。中規模(数万行程度)が、効果とコストの釣り合う領域だと言えるでしょう。
言語については、学習データの蓄積が多い言語ほど生成精度が上がっていきます。普及度の高い言語では精度が出やすく、独自色の強い言語や社内DSLでは精度が落ちてしまいます。
フレームワークについては、規約が明確なものほどAIの生成が安定してくれます。「設定より規約」の思想を持つフレームワークでは、AIが従うべきパターンが定まっているため出力が安定しやすくなります。
逆に、自由度が高く実装パターンが多様なフレームワークでは、AIの出力がプロジェクトの慣習から外れやすくなってしまいます。相性の良し悪しは、AIが参照できる前例の多さに収束していくと言えるでしょう。
導入前に整えておきたい前提条件
導入前の整備は、AIの出力品質を左右する入力条件となります。具体的には、以下の3点です。
1つ目は、テスト基盤の整備です。Agentモードはテストの合否を修正ループの判断材料とするため、テストがなければ自律的な検証が機能しません。テストの不在は、Agentの最大の価値を無効化してしまいます。
2つ目は、設計意図の明文化です。READMEやアーキテクチャ図、命名規則のドキュメントがあるほど、AIは既存の思想に沿った出力を返してくれるようになります。
3つ目は、レビュー体制の確保です。委譲範囲の拡大は人間の検証責任を増やすため、生成物をレビューする時間と担当を、導入と同時に設計しておく必要があるでしょう。
これら3点が未整備のまま導入してしまうと、生成速度だけが上がり、検証が追いつかない状態に陥ってしまいます。Cursor導入の成否は、ツールの設定ではなく、この前提条件の整備度で決まってくると言えるでしょう。
AI駆動開発ならEPICs株式会社
「AI駆動開発に切り替えたいが、どのプロジェクトから始めるべきか判断できない」「ツールは導入したものの、生成速度だけが上がり検証が追いつかない」。そうした課題をお持ちであれば、EPICs株式会社にご相談ください。
当社は、CursorをはじめとするAIエージェントを開発フローへ組み込み、人間が握るべき判断とAIへ委譲する作業の境界を設計したうえで、開発を進めています。ツールの導入それ自体を目的とせず、「そのプロジェクトにAI駆動開発が適しているか」という適性の見極めからご支援します。
新規立ち上げか既存改修か、コードベースの規模・言語・フレームワークとの相性、テスト基盤や設計意図の明文化といった前提条件を確認したうえで、効果の出る適用範囲をご提案します。委譲範囲を広げるほど人間の検証責任が増えるという構造を踏まえ、生成と検証が釣り合う体制づくりまでを設計に含めています。
要件の整理から実装、検証体制の構築、運用定着まで一貫して対応しており、「導入したが品質を担保できない」という状態を、適用前の設計段階から回避へと導きます。
AI駆動開発の導入をご検討の際は、お気軽にお問い合わせください。貴社のプロジェクト特性に合わせた適用範囲をご提案いたします。
この記事を書いた人

関連記事
-
 AI駆動開発の本を「目的別」に厳選!全体像・実務・マネジメント・経営の1冊と実践法
-
AI駆動開発の事例4選!成功企業に共通する3つの条件と始め方を解説
-
AI駆動開発とは?従来開発との違い・メリット・リスク・始め方を体系解説
-
AI駆動開発と仕様駆動開発の違いとは?選定基準・使い分け方を実務視点で解説
-
AI駆動開発のベストプラクティス!フェーズ別の実践指針と組織への定着方法
-
AI駆動開発の要件定義!炎上を防ぐ5つの定義項目と発注側の役割
-
AI駆動開発IDEの選び方!Cursor・Copilot・Windsurf・Cline比較と導入の判断軸
-
AI駆動開発研修で生産性を伸ばす!ツール導入で終わらせないための手順


コメント