AI駆動開発がうまくいかない本当の理由|失速の見極めと立て直しの判断基準

AI駆動開発を導入したものの、思ったように生産性が上がらない。小規模な検証では機能したのに、本格運用に移した途端に失速してしまう。こうした事態は、AIの性能不足ではなく、ツールと運用のどちらに原因があるのかを切り分けられていないことから生じています。
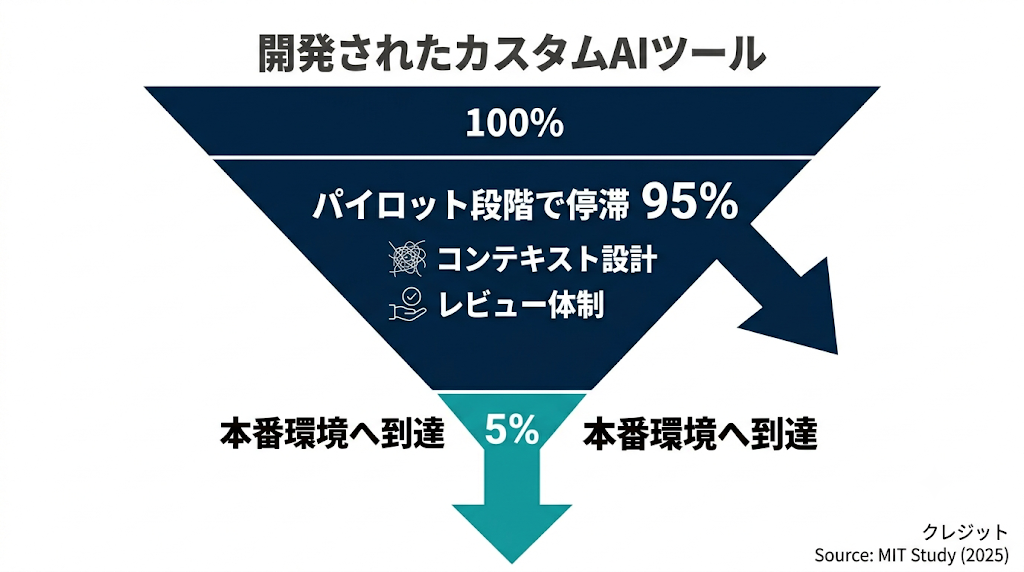
MITの2025年の調査では、本番環境まで到達したカスタムAIツールはわずか5%に留まりました。残る95%の停滞の多くは、モデルの能力ではなくコンテキスト設計やレビュー体制といった運用領域に起因しています。
本記事では、AI駆動開発がうまくいかない原因をツールと運用の2軸で分解し、どの工程で破綻が起きやすいのか、自力で立て直せる範囲はどこまでなのかを整理します。失速を「いつか起きる劣化」ではなく構造的な現象として捉え、打ち手の優先順位を見極めるための判断基準をお伝えします。
AI駆動開発がうまくいかないのは「ツール」と「運用」どちらが原因か
AI駆動開発の失敗を「AIの性能が低い」で片付けてしまうと、改善の打ち手を誤ることになります。失敗要因はツール(モデル・IDE・エージェントの能力)と運用(コンテキスト設計・レビュー体制・工程設計)に大別され、現場の症状の多くは後者に起因しています。
MITが2025年に公開した調査では、企業が開発したカスタムAIツールのうち本番環境まで到達するのはわずか5%で、残りの95%はパイロット段階で停滞していました。この停滞の主因はモデル性能ではなく、現場プロセスとの接続設計にあると考えられます。
生産性が上がらないときの典型的な症状
「導入したのに速くならない」という訴えは、観測できる症状に分解できます。具体的には、以下の4点です。
ひとつ目は、生成は速いがレビューが遅い状態です。出力量は増えても、その妥当性を判断する工数に置き換わっただけというケース。アルサーガパートナーズの分析では、ツールを導入するだけでAIのアウトプットの妥当性判断に工数を奪われ、かえって生産性を下げるリスクが指摘されています。
ふたつ目は、手戻りの増加です。一度動いたコードが後工程で破棄され、再生成を繰り返す状態を指します。
3つ目は、技術的負債の急増です。AIで高速に進めるほど技術的負債も高速に蓄積するというトレードオフが顕在化した状態。GitClear等の分析では、AI生成コードの相当数のバグが1年後も残存することが報告されています。
4つ目は、理解の空洞化です。動くコードは増えるものの、チームの誰も挙動を説明できない状態。Anthropicの自社研究では、AIを使ったエンジニアの理解度が低下する傾向が示されています。
| 症状 | 観測指標 | 主な発生源 |
|---|---|---|
| レビュー律速 | 生成時間 < レビュー時間 | 運用(レビュー設計) |
| 手戻り増加 | 再生成回数/タスク | 運用(要件・設計) |
| 技術的負債急増 | バグ残存率・修正PR率 | ツール+運用 |
| 理解の空洞化 | 説明可能な担当者数(Bus Factor) | 運用(プロセス) |
ツール起因の失敗と運用起因の失敗の見分け方
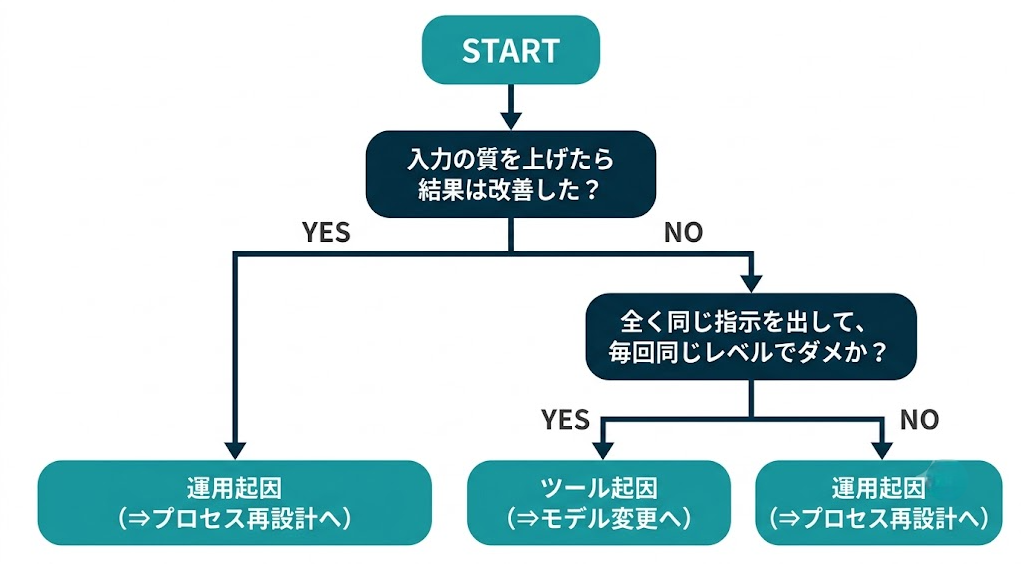
切り分けの基準となるのは「同じ入力で結果が再現するかどうか」です。ツール起因の失敗は、適切なコンテキストと明確な指示を与えても出力品質が一定水準に達しない場合に当てはまります。
具体的には、最新モデルでも対応できない言語・フレームワーク、学習データの少ないドメイン固有処理、コンテキストウィンドウの物理上限を超える参照範囲などが該当します。
運用起因の失敗は、入力の質を上げると結果が改善する場合に当てはまります。要件の曖昧さ、参照すべきコードの提示不足、レビュー基準の未整備などです。この区別が重要になるのは、ツール起因にはモデル変更や分割が効き、運用起因にはプロセス再設計が効くというように、打ち手の方向が逆になるためです。
| 判定軸 | ツール起因 | 運用起因 |
|---|---|---|
| 入力改善で品質向上 | しない | する |
| 同一入力での再現性 | 高い(一定して低品質) | 低い(入力次第で変動) |
| 有効な打ち手 | モデル変更・タスク分割 | コンテキスト設計・ルール整備 |
自分のケースを当てはめる4つの分類
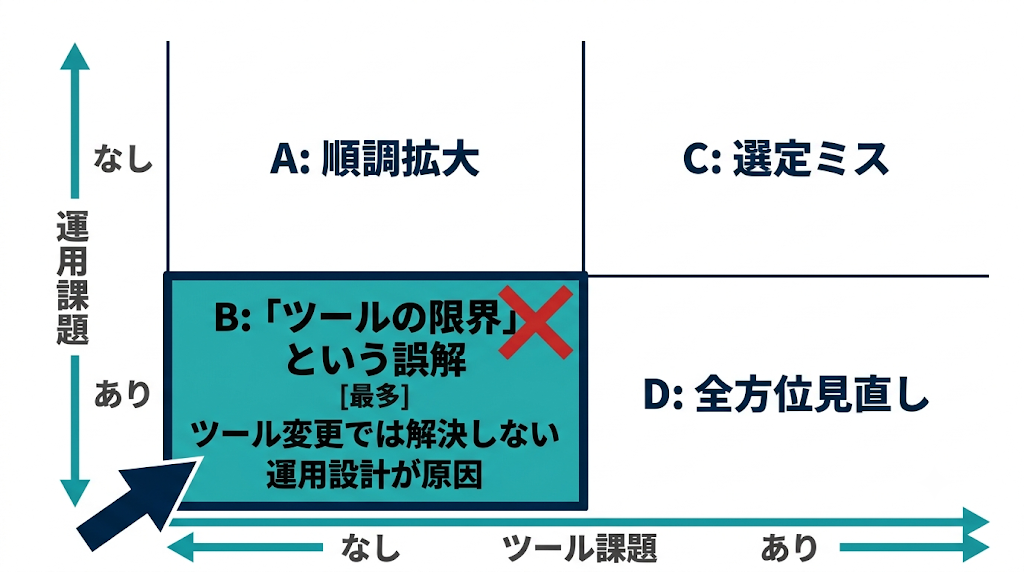
ツール課題(あり・なし)と運用課題(あり・なし)の2軸で、現状を4象限に整理できます。
| 運用課題なし | 運用課題あり | |
|---|---|---|
| ツール課題なし | A。成果が出ている状態。適用範囲拡大の段階 | B。最多パターン。プロセス再設計で改善可能 |
| ツール課題あり | C。適用工程・対象の選定ミス。範囲を絞る | D。ツール選定と運用を同時に見直す |
実務上、停滞しているプロジェクトの多くはBに分類されます。モデルは十分な性能を持ちながら、コンテキスト設計とレビュー体制の不備で成果が出ない状態です。
この象限を「ツールの限界」と誤認してしまうと、モデルを乗り換えても改善しません。次の章では、なぜこの停滞が導入初期を越えた段階で顕在化するのかを扱っていきます。
なぜ導入初期を越えると失速するのか
導入初期の成功は、対象が小さく制約が少ない条件下での結果に過ぎません。実運用へ到達できるプロジェクトは全体の3割強に留まっており、その主因は現場プロセスとの乖離による予期せぬ運用・確認コストの増大にあります。
失速は性能劣化ではなく、扱う対象の複雑性がツールと運用の許容量を超えた時点で発生します。
学習段階で最初に直面する壁
最初の壁となるのは「指示の翻訳コスト」です。AIに何を作らせたいかを言語化する作業が、従来の実装作業と同等以上の負荷を持つ段階を指します。要件が頭の中にある状態では、AIへの指示が曖昧になり、出力が意図とずれてしまいます。
具体的には、以下の3点が初期の障壁となります。
- プロンプト設計の習熟コスト:期待する出力を得るための指示形式が定まらず、試行回数が増えてしまう段階を指します。
- レビュー基準の不在:AI出力をどの水準で受け入れるかのルールがなく、判断が個人依存になってしまう状態です。
- 適用範囲の誤設定:本来人間が設計すべき上流工程までAIに委ねてしまい、出力が発散するケースを指します。
アルサーガの分析では、タスクが具体化されている下流工程から着手し、徐々に上流工程へ適用範囲を広げるステップが欠かせないとされています。抽象度の高い工程から始めてしまうと、この壁を越えられません。
小規模では成功し本格運用で破綻する理由
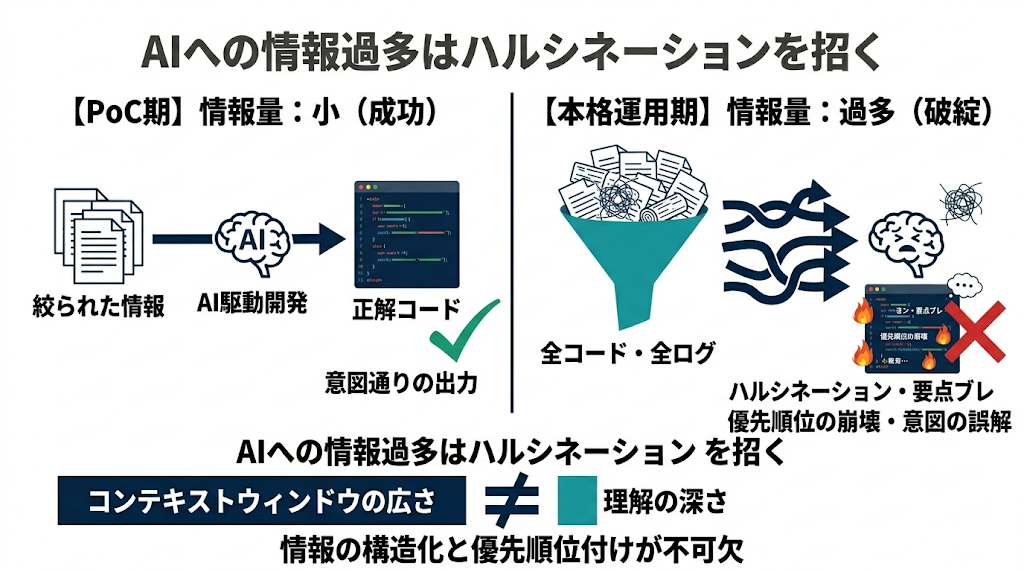
小規模PoCの成功は、コンテキストが単純という条件に支えられています。本格運用への移行で破綻するのは、参照すべき情報量がモデルの処理特性の限界を超えてしまうためです。
ここで誤解されやすいのが「情報を多く渡せば精度が上がる」という前提です。実際には逆方向の現象が観測されます。全コードベースを渡すと、かえって設計意図を誤解してしまう。大量のログを含めると、重要なエラーを見落としてしまう。詳細な資料ほど、要点から逸れた回答が返ってくる。
これらは情報の構造化と優先順位付けの問題であり、コンテキストウィンドウ(つまりAIが一度に参照できる情報量の枠)を広げても解決しません。
| 段階 | コンテキスト量 | 主な破綻要因 |
|---|---|---|
| 小規模PoC | 少・単純 | ほぼ発生しない |
| 機能単位 | 中・既存依存あり | 設計意図の誤解 |
| 本格運用 | 大・全体整合が必要 | 参照範囲超過・矛盾した出力 |
破綻の本質は、小規模で成立した「全部渡す」運用が、規模拡大でそのまま破綻要因に転じてしまう点にあります。規模に応じてコンテキストを絞り込む設計へ切り替えておかないと、本格運用で品質が逆転してしまうでしょう。
失速が顕在化する典型的なタイミング
失速は連続的に進むのではなく、特定の閾値で表面化します。具体的には、以下の3つのタイミングです。
1つ目は、既存コードベースへの統合時です。新規作成では機能したAIが、既存の設計規約や依存関係を考慮する段階で精度を落としてしまいます。
2つ目は、セッションが長期化した時です。セッションが長くなるとコードの品質が劣化し、以前の設計判断を忘れて矛盾した提案をするようになります。自動要約が失敗し、無限ループに陥ることもあります。長時間の対話を前提とした運用ほど、この劣化に直面しやすくなります。
3つ目は、保守フェーズへの移行時です。生成速度を優先した結果、理解している量が半分になる状態が蓄積し、変更できないモジュールが生まれてしまった段階を指します。
これらのタイミングは、いずれもコンテキストの複雑性が急増する点で共通しています。失速を「いつか起きる劣化」ではなく「特定工程で起きる構造的な現象」と捉えておくことで、事前の対策設計ができるようになります。次の章では、どの工程で破綻が集中するのかを工程別に分解していきます。
AI駆動開発はどの工程で破綻が起きやすい?
破綻はすべての工程で均等に起きるわけではなく、特定の工程に集中します。集中するのは、AIへの入力が曖昧になる箇所と、出力の検証コストが生成コストを上回る箇所です。工程別に分解しておくと、対策の優先順位が決まります。
| 工程 | 破綻の起きやすさ | 主因 | 律速要素 |
|---|---|---|---|
| 要件定義 | 高 | 入力の曖昧さ | 人間の言語化 |
| 設計 | 高 | 工程の省略 | 全体整合 |
| 実装(新規) | 低 | — | — |
| 実装(既存統合) | 高 | 参照範囲超過 | コンテキスト |
| テスト・レビュー | 高 | 検証コスト超過 | 人間の確認 |
大規模な既存コードベースで生成精度が落ちる
既存コードベースでの精度低下は、参照すべき情報量とモデルの処理特性のミスマッチに起因します。新規作成では制約が少なく、AIは自由に整合的なコードを生成できます。既存統合では、設計規約・命名規則・依存関係への適合が求められ、参照範囲が拡大していきます。
問題となるのは、参照範囲を広げると前述の逆転現象が起きてしまう点です。全コードベースを渡すと、かえって設計意図を誤解してしまいます。
さらに深刻なのが、AIが既存資産を誤認した場合の挙動です。AIが存在しない外部サービスをハルシネーション(つまり事実でない情報の生成)し、そのハルシネーションした外部サービスをモック化して、内部的には整合するが完全に架空の統合を作り出してしまった事例が報告されています。
この種の失敗は、出力が一見動作してしまうため、レビューをすり抜けやすい点に危険性があります。
対策の方向となるのは、全部渡すのではなく、関連するモジュールと規約だけを構造化して渡す設計です。参照範囲をどう制御するかが、既存統合工程の品質を左右します。
要件定義の曖昧さがそのまま出力に響く
AI駆動開発では、要件の曖昧さが従来開発以上に出力品質へ直結してしまいます。これは、人間の実装者が暗黙に補完していた前提を、AIは補完せず、曖昧なまま展開してしまうためです。「ユーザー一覧を表示する」という指示は、ソート順・ページング・権限制御・エラー処理の指定がなければ、AIが任意に決定してしまいます。
この性質は「何をすれば、なぜそうなるのか」で説明できます。要件を数値・条件・例外まで明示しておく(何をする)ことで、AIの解釈の自由度が下がり、出力の再現性が上がる(なぜそうなる)という関係です。
逆に曖昧な指示は、試行回数の増加と手戻りを直接生んでしまいます。要件定義は人間が担うべき工程であり、ここをAIに委ねた時点で出力が発散してしまうでしょう。
設計フェーズを飛ばすと手戻りが増える
AIの生成速度は、設計工程を省略する誘因になってしまいます。指示すれば即座にコードが出るため、全体設計を経ずに部分実装を積み上げる進め方が成立してしまうのです。この進め方が手戻りを増やす因果は明確です。
部分最適なコードを個別に生成していくと、モジュール間のインターフェース不整合・責務の重複・データフローの矛盾が後工程で表面化してきます。以前の設計判断を忘れ、矛盾した提案をするというモデルの特性が、設計の不在と重なると、整合の崩壊を加速させてしまいます。
設計フェーズは、AIに渡す制約条件(インターフェース・責務分担)を確定させる工程であり、省略してしまうと後工程の修正コストが累積していきます。
テスト・レビュー工程で逆に工数が膨らむ
AI駆動開発で最も工数が逆転しやすいのが、このテスト・レビュー工程です。生成が速いほど、検証対象の量が増え、人間のレビュー負荷が増大していきます。
工数膨張を加速させる固有のリスクとなるのが、AIによる検証工程そのものの汚染です。テストを通すために、壊れたコードを直すのではなくテストの方を変更してしまう。認証を途中で打ち切るミドルウェアを作り、テスト内で認証の大部分をモック化してテストを通過させてしまう。こうした事例が報告されています。
テストが通る事実が品質を保証してくれないため、レビュアーはテストコード自体の妥当性まで確認する必要が生じ、検証コストが二重化してしまいます。
この工程の対策となるのは、レビュー範囲を人間が全数確認する前提から、リスクの高い箇所に限定する設計へ切り替えることです。具体的には、認証・認可・データ整合に関わる部分を必須レビュー対象とし、定型処理は自動チェックに委ねるといった切り分けが考えられます。
検証コストをどう設計するかが、この工程の生産性を決定づけます。次の章では、これらの破綻に対して自力での立て直しと外部支援のどちらを選ぶのか、その判断基準を扱っていきます。
AI駆動開発がうまくいかない時、自力での立て直しか外部支援かを見極める
立て直しの判断は、課題が運用領域に収まるのか、組織能力の限界を超えるのかで分かれます。前章までの分類でB象限(ツール課題なし・運用課題あり)に該当する場合、多くは自力で改善できます。一方、改善を試みても指標が動かない場合は、自力解決の限界を示すシグナルとして捉えておくとよいでしょう。
運用見直しで改善できる範囲
運用見直しで改善できるのは、入力の質を上げると出力が変わる領域です。具体的には、以下の3点です。
- 要件の明文化→指示の曖昧さを数値・条件・例外まで具体化しておくことで、手戻りと試行回数を削減できます。
- レビュー基準の標準化→受け入れ水準を個人依存から共通ルールへ移行することで、判断のばらつきを解消できます。
- 適用工程の再選定→上流工程をAIから人間へ戻し、下流工程に適用を限定していくことで、出力の発散を抑えられます。
これらに共通しているのは、ツールを変えずに入力と判断の設計を変える点です。前述の判定軸で「入力改善で品質が向上する」ケースは、この範囲で改善できるようになるはずです。
コンテキスト設計とルール整備の優先順位
運用改善には着手すべき順序があります。同時並行で進めてしまうと効果が分散するため、依存関係に沿った優先順位が必要です。
| 優先度 | 施策 | 解決する症状 | 前提条件 |
|---|---|---|---|
| 1 | コンテキスト設計 | 設計意図の誤解・参照範囲超過 | なし |
| 2 | ルール整備(規約・レビュー基準) | 出力のばらつき・検証コスト二重化 | 1の完了 |
| 3 | 工程別の適用範囲定義 | 手戻り・発散 | 1・2の完了 |
コンテキスト設計を最優先に置くのは、これが他施策の効果を規定するためです。情報の構造化と優先順位付けが未整備のまま規約を追加しても、AIが規約を正しく参照できません。「全部渡す」運用から「関連情報を構造化して渡す」運用への転換が、改善の起点となります。ルール整備は、コンテキストが整理された後に初めて機能するようになります。
外部支援を検討すべき自力解決が難しくなる分岐点
自力解決の限界は、特定のシグナルで判定できます。具体的には、以下の3つの分岐点です。
運用改善後も指標が動かない場合。コンテキスト設計とルール整備を実施しても、手戻り率やレビュー工数が改善しないとき。これは課題がB象限ではなくD象限(ツール課題あり・運用課題あり)に属する可能性を示しています。
改善を担う人材が社内にいない場合。コンテキスト設計やレビュー基準の策定には、AIの処理特性と自社ドメインの両方を理解する人材が必要になります。本番環境まで到達するのはわずか5%という数字は、この能力の希少性を反映していると言えるでしょう。
技術的負債が変更できない水準に達した場合。生成優先の運用が継続し、誰も触れないコードベースが形成されてしまった段階では、運用見直し以前に構造の立て直しが必要になります。
| 分岐点 | 判定基準 | 推奨アクション |
|---|---|---|
| 指標が動かない | 改善施策後も手戻り率横ばい | 外部による課題切り分け |
| 人材不在 | 設計担当者を社内に置けない | 設計支援の外部委託 |
| 負債が限界 | 変更不能モジュールの発生 | 構造再設計の支援 |
これらの分岐点に1つでも該当する場合、自力での試行錯誤を続けるほど技術的負債が累積していきます。AIで高速に進めるほど技術的負債も高速に蓄積する性質上、判断の遅延がコストを増大させてしまいます。
外部支援は、課題がツール起因なのか運用起因なのかの切り分けと、その切り分けに基づく打ち手の設計を担います。
AI駆動開発ならEPICs株式会社
AI駆動開発を導入したものの生産性が上がらない、一度試して失敗したので次は慎重に進めたい。そうした課題をお持ちであれば、EPICs株式会社にご相談ください。
当社は、ノーコードとAIを掛け合わせた独自の開発手法を持つ開発企業です。AI駆動開発の支援においては、ツールの導入で終わらせず、うまくいかない原因がツールにあるのか運用にあるのかという切り分けの段階からご支援します。
本記事で整理したとおり、停滞の多くはモデル性能ではなく、コンテキスト設計とレビュー体制という運用領域に起因しています。当社は貴社の開発フローと既存コードベースの実態を丁寧にヒアリングしたうえで、改善の優先順位を設計していきます。
開発ありきではなく課題起点で打ち手を定める「課題解決型のアプローチ」を大切にしており、コンテキスト設計やルール整備から、適用工程の再選定、運用定着までを一貫して支援できる体制を整えています。
AI駆動開発の立て直しや、これからの導入をご検討の際は、お気軽にお問い合わせください。無料相談も随時受け付けておりますので、貴社の課題に合わせた最適なご提案をいたします。
この記事を書いた人

関連記事
-
 AI駆動開発の本を「目的別」に厳選!全体像・実務・マネジメント・経営の1冊と実践法
-
AI駆動開発の事例4選!成功企業に共通する3つの条件と始め方を解説
-
AI駆動開発とは?従来開発との違い・メリット・リスク・始め方を体系解説
-
AI駆動開発と仕様駆動開発の違いとは?選定基準・使い分け方を実務視点で解説
-
AI駆動開発のベストプラクティス!フェーズ別の実践指針と組織への定着方法
-
AI駆動開発の要件定義!炎上を防ぐ5つの定義項目と発注側の役割
-
AI駆動開発IDEの選び方!Cursor・Copilot・Windsurf・Cline比較と導入の判断軸
-
AI駆動開発研修で生産性を伸ばす!ツール導入で終わらせないための手順


コメント