AI駆動開発のコードレビュー完全ガイド!誤りの型・分担の線引き・自動化ツール設定まで

AI駆動開発の普及により、コードを生成するスピードは大きく向上しました。一方で、生成されたコードをどうレビューするかという課題が、品質を左右する分岐点となりつつあります。
AI生成コードは構文的に整い、テストも通過し、一見すると問題なく動作します。しかし動くことと品質が担保されていることは別問題。設計意図のずれやセキュリティの盲点は、テストの緑だけでは検出できません。
本記事では、AI生成コードに潜む4つの誤りの型を整理したうえで、人間とAIのレビュー分担の線引き、自動化ツールの選定とCI/CDへの組み込み方、レビュー基準のルール化までを解説します。生成速度の向上を技術的負債の蓄積に変えないための、実務的なレビュー設計の考え方をまとめました。
なぜAI駆動開発のコードは「動くのにレビューを通してはいけない」のか
AI生成コードのレビューにおける最大の誤解は、テストが通れば品質は担保されるという前提にあります。実際には、動作確認とレビュー通過は別問題。動くコードは要件のごく一部を満たした状態に過ぎず、保守性・セキュリティ・設計整合性という残りの評価軸は未検証のまま残ります。
AI生成コードが「それらしく動く」仕組み
大規模言語モデルは、学習データ上で次に来る確率の高いトークンを予測してコードを生成します。つまり、正しさではなくもっともらしさを最適化する構造。この特性が、構文的に整合し、命名規則も自然で、一見レビュー済みに見えるコードを生み出します。
問題は、もっともらしさと正しさが一致する保証がない点にあります。学習データに頻出するパターンであれば両者は高確率で一致しますが、自社固有の要件やエッジケースでは乖離してしまいます。生成物の見た目の完成度が、レビュアーの警戒心を下げる方向に働いてしまうという構造的なリスクが存在します。
設計意図を持たないコードが破綻するポイント
人間が書くコードには、なぜこの実装を選んだかという意図が伴います。AIは要件の文字列から確率的に実装を導くため、この意図が欠落してしまいます。結果として、局所的には正しいものの全体設計と矛盾するコードが生成されることになります。
破綻が顕在化するのは、具体的には以下の3つの局面です。
| 破綻局面 | 発生メカニズム | 顕在化のタイミング |
|---|---|---|
| 状態管理の不整合 | 各関数が独立に「正しく」生成され、共有状態の前提がずれる | 複数機能の結合時 |
| 例外処理の方針不統一 | エラー処理がファイルごとに異なる流儀で実装される | 障害発生時の追跡 |
| 拡張時の構造矛盾 | 既存設計の制約を踏まえず最短経路で実装される | 機能追加・改修時 |
これらは生成直後のテストでは検出されません。設計意図というコードに書かれない情報の欠落が原因のため、コードを読むだけでは判別が難しいのが特徴。要件と照合して初めて検出できるようになります。
テスト通過と品質担保のあいだにあるギャップ
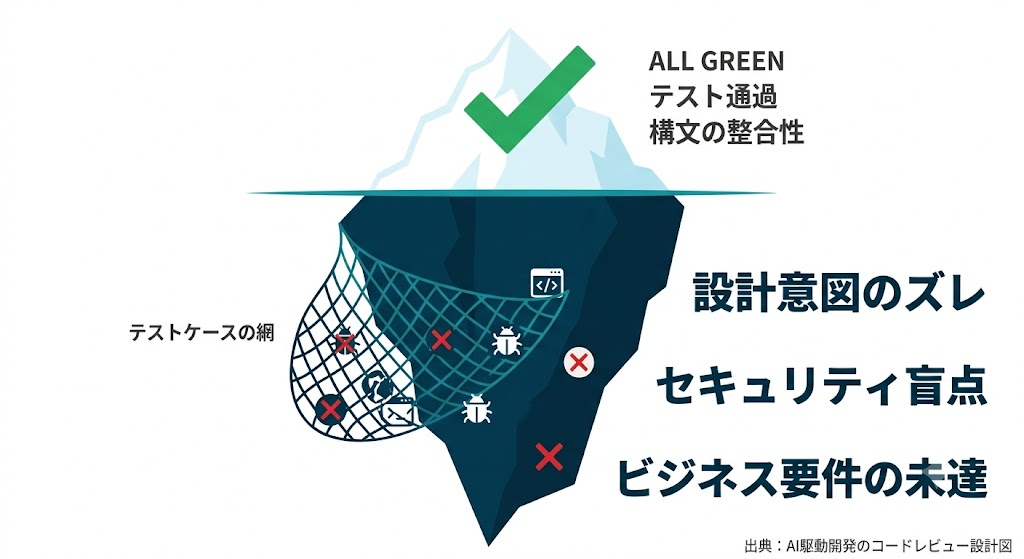
テストが検証するのは、テストケースで定義された範囲の動作に限定されます。AIが生成したコードに対しAIがテストを生成する構成では、このギャップが拡大してしまいます。生成コードの誤った前提が、そのままテストの前提として再生産されてしまうためです。
| 評価軸 | テストで検証可能か | 検証手段 |
|---|---|---|
| 機能の正常動作 | 可能 | 自動テスト |
| 境界値・異常系 | ケース設計に依存 | テストケースの網羅性 |
| 設計整合性 | 不可 | 人間によるレビュー |
| ビジネス要件の充足 | 不可 | 要件定義との照合 |
| セキュリティ妥当性 | 部分的 | 静的解析+人間判断 |
テスト通過は品質の必要条件であって、十分条件ではありません。緑のテスト結果を品質の証明と捉える運用が、レビュー軽視を招く最初の入口になってしまいます。
速度の向上と品質リスクの表裏一体性
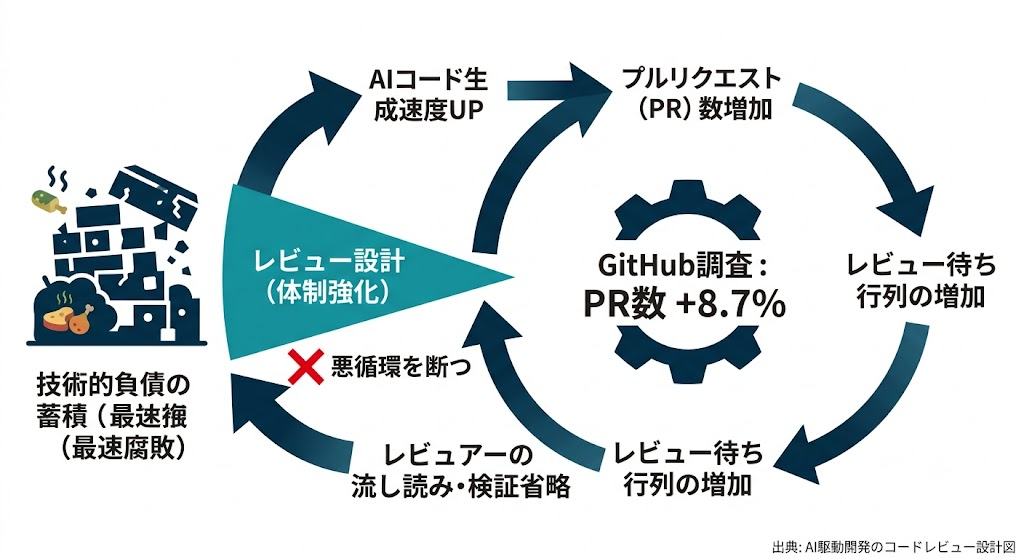
AIコード生成の利点は生成速度にあります。同時に、レビュー対象となるコード量も増加。GitHubとAccentureの調査では、Copilot導入でプルリクエスト数が約8.7%増加したと報告されています。生成が速くなるほど、レビューがボトルネックへ移動していく構造です。
ここで生じるトレードオフを整理します。
| 項目 | AI導入による変化 | 派生するリスク |
|---|---|---|
| コード生成速度 | 向上 | レビュー待ち行列の増加 |
| 1人あたり生成量 | 増加 | レビュアーの処理能力超過 |
| レビュー対象の見た目 | 完成度が向上 | 警戒心の低下・流し読み |
| 検証コスト | 相対的に増大 | レビュー省略への誘惑 |
レビュアーの検出効率は、80〜100行を超えると低下することが知られています。生成量の増加は、この閾値を超えるレビュー負荷を常態化させてしまいます。
速度を品質に転換する装置がレビュー体制であり、生成の高速化と同じ比率でレビュー体制を強化していかなければ、速度向上はそのまま技術的負債の蓄積速度に変わってしまうでしょう。
AI生成コードに潜む4つの誤りの型
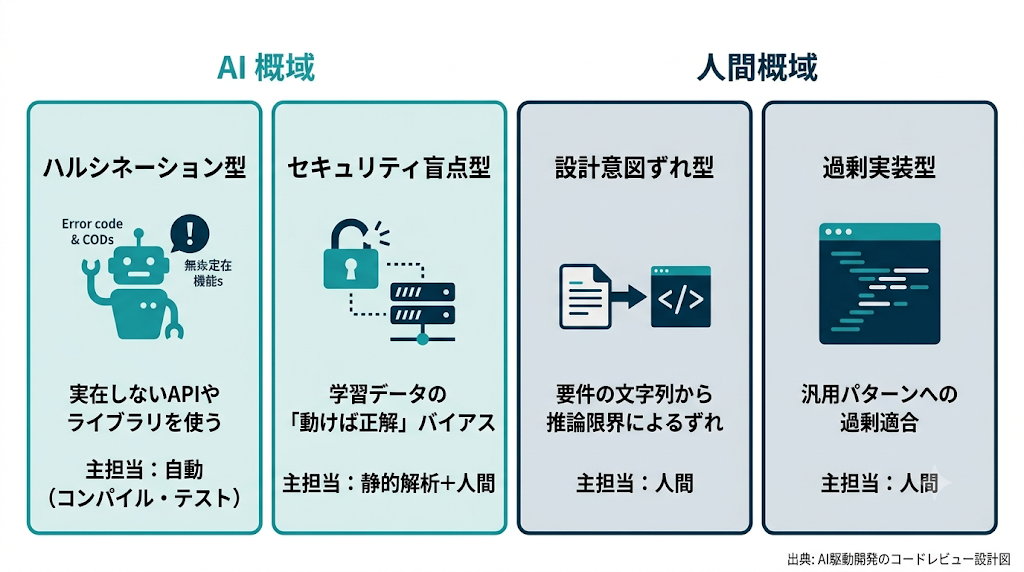
AI生成コードの誤りは無秩序に発生するのではなく、生成メカニズムに由来する4つの型に分類できます。型を識別できれば、レビューの着眼点を事前に固定でき、検出漏れを減らせるようになります。
| 誤りの型 | 根本原因 | 検出の主担当 |
|---|---|---|
| ハルシネーション型 | 確率的生成による架空要素の創出 | 自動(コンパイル・テスト) |
| 設計意図ずれ型 | 要件の文字列からの推論限界 | 人間 |
| セキュリティ盲点型 | 学習データの「動けば正解」バイアス | 静的解析+人間 |
| 過剰実装型 | 汎用パターンへの過剰適合 | 人間 |
存在しないAPIやライブラリを使う「ハルシネーション型」
ハルシネーションとは、AIが存在しない情報を事実のように生成する現象のこと。コードでは、実在しないメソッド、引数の異なる関数シグネチャ、リポジトリに存在しないライブラリの呼び出しとして現れます。
この型の特徴は、検出が比較的容易な点にあります。コンパイル時または依存解決時にエラーとなるため、ユニットテストや型システムが第一の防御線として機能してくれます。AIが架空のメソッドを生成しても、実行時に即座にエラーとなり、そのエラーメッセージをAIへ返すことで自動修正を回すことができます。
ただし注意したい点が一つ。動的型付け言語かつテスト未整備の経路では、ハルシネーションが実行時まで潜伏してしまいます。型システムとテストカバレッジの薄い領域ほど、この型の検出コストが上昇してしまう関係です。
要件とずれた実装を生む「設計意図ずれ型」
4つの型のうち、最も検出が難しい型。コードは構文的に正しく、テストも通過し、単体では妥当に見えます。しかし要件が意図したものと異なる実装になってしまっています。
具体例として、以下のようなずれが生じます。
| 要件の意図 | AI生成の実装 | ずれの性質 |
|---|---|---|
| 在庫数が0未満を禁止 | 0未満でも保存し表示時に補正 | 制約位置の誤り |
| 論理削除での履歴保持 | 物理削除で実装 | データ方針の誤り |
| 既存の認証基盤を利用 | 独自の認証ロジックを新設 | 設計方針の逸脱 |
このずれは、AIが要件の文字列から確率的に最短実装を導くために発生します。コードを読むだけでは検出できず、要件定義・既存設計との照合が欠かせません。レビュアーがコードの正しさではなく要件との一致を問う姿勢に切り替えていかなければ、テストの緑とともに本番へ流出してしまいます。
入力検証や権限を見落とす「セキュリティ盲点型」
AIは、動作する正常系を優先して生成する傾向があります。結果として、入力検証・権限チェック・エスケープ処理といった、正常系では発火しない防御コードが欠落しやすくなってしまいます。
| 盲点の対象 | 欠落しやすい理由 | 顕在化の経路 |
|---|---|---|
| 入力値検証 | 正常入力では不要に見える | 不正入力・インジェクション |
| 認可チェック | 機能要件に明記されないことが多い | 権限昇格・越権アクセス |
| 出力エスケープ | 正常データでは問題化しない | XSS等の注入攻撃 |
| 機密情報の扱い | 学習データにハードコード例が多い | 認証情報の漏えい |
この型は、機能テストでは検出されない点でセキュリティ上のリスクが大きくなります。正常系のテストがすべて通過しても、防御コードの欠落は残ったまま。静的解析ツールで一次検出し、認可とビジネスロジックの妥当性は人間が判断する二段構えが必要となります。
学習データに認証情報のハードコード例が多く含まれることも、AIが同種のアンチパターンを再生産する確率を高めてしまいます。
過剰な抽象化や不要コードを生む「過剰実装型」
要件に対し実装が過剰になってしまう型。AIが汎用的なお手本パターンに過剰適合し、現時点で不要な抽象化や拡張ポイントを生成してしまいます。
| 過剰実装の現れ方 | 具体的な症状 | 派生コスト |
|---|---|---|
| 早すぎる抽象化 | 1実装しかないのにインターフェース化 | 可読性の低下 |
| 未使用の拡張点 | 使われない設定項目・引数 | 保守対象の増加 |
| 過剰なエラー処理 | 発生し得ない例外の網羅 | コード量の肥大 |
| 重複ロジックの再生成 | 既存の共通関数を使わず再実装 | DRY原則の破壊 |
この型は動作に支障がないため見逃されやすく、技術的負債として蓄積してしまいます。コード量の増加はレビュー負荷とバグ混入面積に直結。動くが過剰なコードは、削除提案という形でレビューが介入すべき対象となります。YAGNI(必要になるまで作らない)の原則をレビュー基準に明示しておくことで、この型の流入を抑制できるでしょう。
人間とAIのレビュー分担はどこで線を引くか
分担の原則は、機械的に検証可能な領域はAI、文脈判断が必要な領域は人間という線引きにあります。この線引きを曖昧にすると、AIに設計判断を委ねて品質が劣化するか、人間が構文チェックに時間を費やして生産性が損なわれるかの、どちらかに振れてしまいます。
判断基準は、正解がコードの外にあるか内にあるか。規約やAPI仕様のように正解が明文化された領域はAIが、要件や事業文脈のように正解がコード外の暗黙知に依存する領域は人間が担当します。
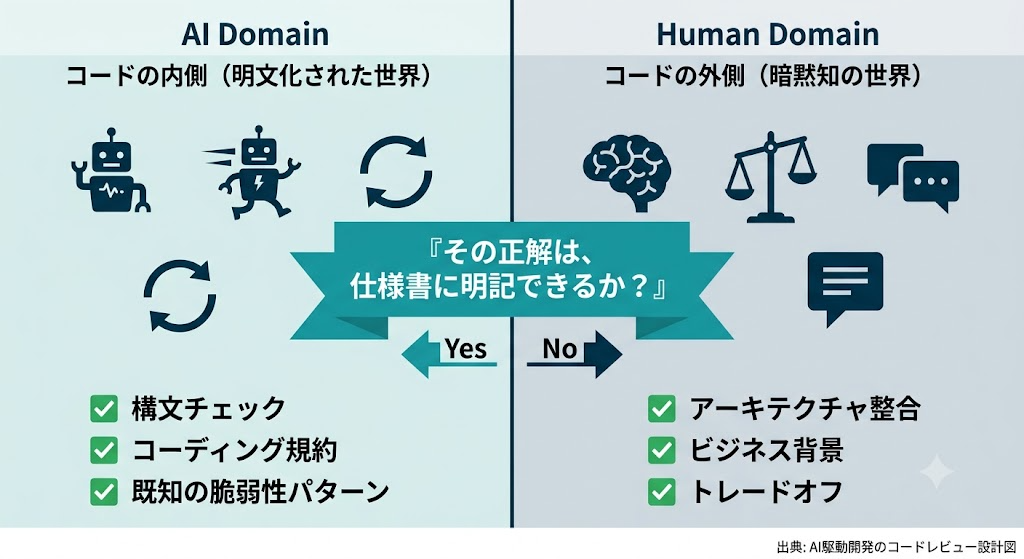
AIに任せられる領域(構文チェック・規約準拠・定型バグ検出)
AIが優位を持つのは、判断基準が明文化され、大量処理で疲労しない領域です。レビュアーの検出効率は80〜100行で低下しますが、AIにこの劣化はありません。
| AI担当領域 | 委任できる理由 | 期待される効果 |
|---|---|---|
| 構文・スタイル準拠 | 規約がルールとして明文化済み | 指摘の即時化・網羅 |
| 定型バグ検出 | パターンが既知で再現性が高い | null参照・未処理例外の機械検出 |
| 命名・可読性の一次指摘 | 規約への適合判定が機械的 | 人間レビューの前処理 |
| 既知の脆弱性パターン | シグネチャ照合で判定可能 | セキュリティ盲点の一次検出 |
この領域をAIへ委任する意義は、人間のレビュー資源を温存できる点にあります。構文レベルの指摘でレビュアーの集中力を消費させない構成が、後段の設計レビューの精度を上げてくれます。
人間が担うべき領域(設計判断・ビジネス要件の整合)
人間が担うのは、正解がコードの外にある領域です。AIは要件の文字列とコードを照合できますが、文字列化されていない事業上の制約・優先順位・将来計画は判断材料に含められません。
| 人間担当領域 | AIに委任できない理由 |
|---|---|
| 設計方針の妥当性 | 既存アーキテクチャとの整合は暗黙知に依存 |
| ビジネス要件の充足 | 要件の真の意図は仕様書に書き切れない |
| トレードオフの選択 | 速度と保守性の優先順位は事業判断 |
| 影響範囲の見極め | 組織・運用の文脈を要する |
DMMの事例では、AIがプルリクエストをスコアリングして自動承認する仕組みを構築し、精度面では成立したものの、チームに定着しなかったと報告されています。
この結果が示しているのは、レビューの本質が意図の共有にあり、その部分を機械へ移譲すると組織的に成立しなくなるという構造です。AI生成コードがAIが生成したから正しいという主張で擁護され炎上した事例も、責任の所在を人間が担う原則の重要性を示しています。
参考:AIが教えてくれたコードレビューの本質 ― 意図共有という学び ―
AIレビューと人間レビューの組み合わせ順序
順序の原則は、AIを前段、人間を後段に固定すること。AIが機械的検証を済ませた状態を人間レビューの入力とすることで、人間は設計とビジネス整合に集中できるようになります。
| 段階 | 担当 | 処理内容 | 通過条件 |
|---|---|---|---|
| 第1段 | 自動 | コンパイル・テスト・静的解析 | エラーゼロ |
| 第2段 | AI | 規約準拠・定型バグ・脆弱性パターン | 指摘の解消 |
| 第3段 | 人間 | 設計判断・要件整合・トレードオフ | 承認 |
この順序を逆転させ、人間が先に構文を見る運用は、資源配分として非効率。逆に、AIの承認をもって最終承認とする運用は、第3段の判断を欠落させてしまいます。最終承認の権限と責任は人間に残しておくことが大切。AIは人間の判断を支援する前処理装置であり、置換装置ではないという位置づけが、分担設計の基準点になります。
AI駆動開発で使えるコードレビュー自動化ツールと設定
ツール導入の目的は、人間レビューの前段を自動化し、設計判断へ資源を集中させることにあります。ツール選定・パイプライン組み込み・レビュー基準の言語化という3点を設計していかなければ、ツールは指摘ノイズを増やすだけの存在になってしまいます。
AIコードレビューツールの種類と特徴
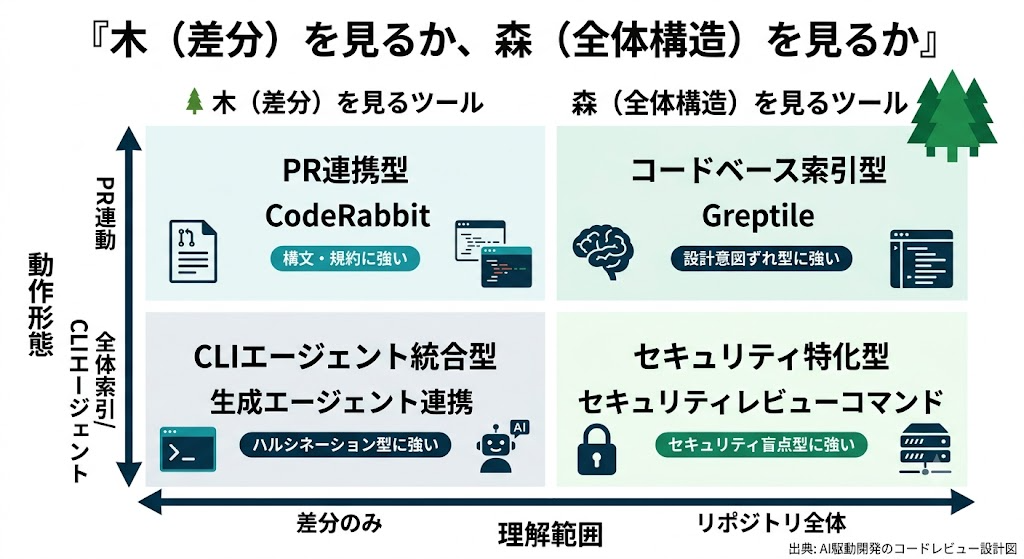
AIコードレビューツールは、動作環境と理解範囲の2軸で分類できます。コードベース全体を理解するか差分のみを見るか、どこで実行するかが選定基準となります。
| 種類 | 動作形態 | 理解範囲 | 適する場面 |
|---|---|---|---|
| PR連携型 | プルリクエスト単位で自動レビュー | 差分中心 | 既存ワークフローへの組み込み |
| コードベース索引型 | リポジトリ全体をインデックス化 | 全体構造 | 設計整合性の検出 |
| CLI/エージェント統合型 | ターミナル・生成エージェントと連携 | 生成過程に組み込み | 生成直後の即時検証 |
| セキュリティ特化型 | 脆弱性検出に専念 | セキュリティ観点 | 盲点型の一次検出 |
2025年時点で、PR連携型のCodeRabbit、コードベース索引型のGreptile、生成エージェントに統合されたセキュリティレビューコマンド、AIと人間を組み合わせるハイブリッド型が普及しています。索引型は前章で述べた設計意図ずれ型の検出に寄与し、差分型では捉えにくい全体矛盾を補える点が分岐点となります。
ツール選定時の判断軸を整理します。
| 判断軸 | 確認すべき内容 |
|---|---|
| コードベース理解 | 差分のみか全体索引か |
| 偽陽性率 | 無効な指摘の頻度がレビュー疲労を左右 |
| 既存基盤との統合 | 利用中のGit基盤・CIへの接続性 |
| ルールのカスタム性 | 自社規約をルール化できるか |
偽陽性率の評価を軽視すると、無効な指摘が累積してレビュアーがツールの指摘を無視し始め、導入が形骸化してしまいます。
CI/CDパイプラインへの組み込み方
組み込みの原則は、機械的検証を人間レビューより前に強制すること。AIレビューを任意の補助ではなくパイプラインのゲートに組み込むことで、未検証コードの後段流入を構造的に防げるようになります。
| ステージ | 実行内容 | 不合格時の挙動 |
|---|---|---|
| ビルド・テスト | コンパイル・自動テスト・型チェック | パイプライン停止 |
| 静的解析 | 既知脆弱性・コード品質の機械検出 | 指摘をPRへ反映 |
| AIレビュー | 規約準拠・定型バグの自動指摘 | コメント自動付与 |
| 人間承認 | 設計・要件整合の最終判断 | マージ可否決定 |
設計上の注意点が2つあります。第一に、AIレビューを必須ゲートにするか参考扱いにするかの線引き。偽陽性率が高い段階で必須ゲート化すると、有効なPRが滞留してしまいます。
第二に、AIの自動承認を最終承認としない構成。自動承認の仕組みは精度面で成立しても、最終判断を人間に残さなければ組織的に定着しません。AIレビューはコメント付与までを担い、マージ権限は人間に保持させる構成が安全と言えるでしょう。
レビュー基準のプロンプト・ルール化
AIレビューの精度は、基準の言語化品質に左右されます。基準が曖昧なら指摘も曖昧になり、明文化された規約をルールへ落とすほど指摘が安定していきます。汎用設定のままでは、自社固有の設計意図ずれ型を検出できません。
ルール化すべき対象を、検出したい誤りの型と対応づけます。
| ルール化の対象 | 対応する誤りの型 | 記述例の方向性 |
|---|---|---|
| 自社コーディング規約 | 過剰実装型・可読性 | YAGNI・命名規則の明示 |
| 認可・入力検証の必須化 | セキュリティ盲点型 | 検証なしの入力受付を禁止 |
| 既存基盤の利用方針 | 設計意図ずれ型 | 認証は既存基盤を利用と明記 |
| 依存ライブラリの許可リスト | ハルシネーション型 | 未承認ライブラリの導入を警告 |
ルール記述の原則は、禁止と必須を具体的な条件で書くこと。読みやすくのような抽象表現はAIの判定を不安定にしてしまいます。1実装しかないインターフェースを指摘する、認可チェックのないエンドポイントを指摘するという条件形式が、判定の再現性を高めてくれます。
運用上、ルールは固定ではなく更新対象です。レビューで人間が繰り返し指摘する観点をルールへ反映し、AIへ移譲していく。この循環が、人間レビューの資源を設計判断へ集中させる継続的な仕組みになっていくでしょう。
AI駆動開発ならEPICs株式会社
「AIにコードを書かせる体制は整えたが、生成されたコードをどうレビューすればいいかわからない」「開発速度は上がったが、品質リスクが見えず本番投入に踏み切れない」。そうした課題をお持ちであれば、EPICs株式会社にご相談ください。
当社は、ノーコードとAIを掛け合わせた開発を手がけるAI駆動開発企業です。コードを生成して終わりではなく、本記事で整理した4つの誤りの型を踏まえたレビュー体制の設計までを一貫してご支援します。
AIに任せる領域と人間が判断すべき領域の線引き、CI/CDパイプラインへのAIレビュー組み込み、自社要件に合わせたレビュー基準のルール化。これらを開発体制とセットで構築していくことで、生成速度の向上を品質劣化につなげない仕組みをご提供します。
開発ありきではなく、課題の整理段階からご支援する課題起点のアプローチを大切にしており、要件定義から開発、レビュー体制の定着、継続的な改善まで対応しています。
AI駆動開発の品質担保にお悩みの方は、まずはお気軽にご相談ください。無料相談も随時受け付けております。貴社の開発フローに合わせた最適なご提案をいたします。
この記事を書いた人

関連記事
-
 AI駆動開発の本を「目的別」に厳選!全体像・実務・マネジメント・経営の1冊と実践法
-
AI駆動開発の事例4選!成功企業に共通する3つの条件と始め方を解説
-
AI駆動開発とは?従来開発との違い・メリット・リスク・始め方を体系解説
-
AI駆動開発と仕様駆動開発の違いとは?選定基準・使い分け方を実務視点で解説
-
AI駆動開発のベストプラクティス!フェーズ別の実践指針と組織への定着方法
-
AI駆動開発の要件定義!炎上を防ぐ5つの定義項目と発注側の役割
-
AI駆動開発IDEの選び方!Cursor・Copilot・Windsurf・Cline比較と導入の判断軸
-
AI駆動開発研修で生産性を伸ばす!ツール導入で終わらせないための手順


コメント