AI駆動開発のセキュリティ対策!情報漏洩を防ぐ役割分担と導入フェーズ別マップ

AI駆動開発の導入が進む一方で、生成コードの安全性が新たな課題として浮上しています。Veracodeの調査では、AIが生成したコードの45%が安全性に問題を抱えていると報告されており、「動くコード」をそのまま本番環境へ移送するリスクが現実のものとなっています。
問題の本質は、コード品質そのものよりも、AIの生成速度に人手のレビュー体制が追いつかない構造にあります。生成速度がレビュー速度を上回ると、未検証のコードが本番へ流入し、脆弱性や情報漏洩の温床となってしまうでしょう。
本記事では、AIが書いたコードに潜む危険性の正体から、情報漏洩の3つの経路、セキュリティ責任の役割分担、導入フェーズごとの対応策までを体系的に整理します。AI駆動開発の生産性を取り込みながら、安全性をいかに担保するか。その具体的な設計指針をお伝えします。
なぜ「AIが書いたコード」は人間のコードより危険なのか
AIが生成したコードの危険性は、コード品質そのものではなく、検証プロセスを通過しやすい構造に起因します。Veracodeの調査では、バイブコーディング(AIにプロンプトを送信してプログラムを得る手法)で生成されたコードの45%が安全性に問題を抱えていると報告されています。
問題は、この45%が「動作する」がゆえにレビューをすり抜けてしまう点にあります。
AIは「動くコード」と「安全なコード」を区別しない
AIの最適化目標は「要求された機能を満たすコードの出力」であり、「攻撃耐性の確保」ではありません。両者は別の評価軸となります。
具体的な乖離の例として、現場で確認された事象が以下です。
| 機能要件は満たすが安全性を欠く事象 | 発生する脆弱性 |
|---|---|
| JWT(認証トークン)の署名検証を実装しない | 改ざんトークンが検知されず通過 |
| 入力値検証を省略する | SQLインジェクション・XSSの起点 |
| セキュリティヘッダ(CSP等)を付与しない | クライアント側攻撃の防御欠如 |
| アクセスキーをコードに直書きする | 認証情報の漏洩 |
いずれもテスト環境では正常に動作します。動作確認を「検査完了」と誤認した時点で、脆弱性は本番環境へ移送されてしまいます。AIは「動く」を達成した時点で出力を終えるため、安全性の欠落は指摘されない限り表面化しません。
学習データに潜む古い脆弱なコードの再生産
AIモデルは過去のコードを学習データとして取り込みます。この中には、公開当時は許容されていたものの、現在は非推奨となった実装パターンも含まれます。
因果関係は単純です。学習データの分布が過去のコードに偏ることで、モデルは統計的に出現頻度の高いパターンを再生産します。結果として、SQLインジェクションやXSSに対して脆弱な旧式の書き方が提案されてしまうわけです。AIは「最新の安全な書き方」ではなく「学習データ上で多数派の書き方」を出力する性質を持っています。
さらに「パッケージハルシネーション」という派生リスクも存在します。これは、AIが実在しないライブラリ名を推奨する現象のこと。攻撃者がその架空の名称で悪意あるパッケージを公開し、開発者にインストールさせる手口(スロップスクワッティング)も確認されています。存在しないはずの依存先が、攻撃の侵入口へ変わってしまう構造です。
「AIが書いたから安全」という思い込みの危うさ
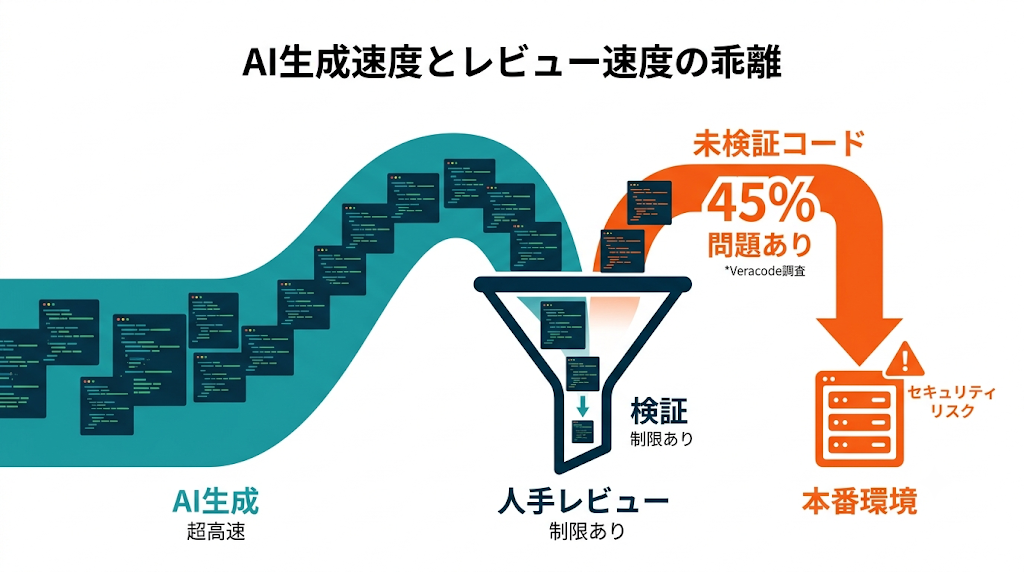
最大のリスクは技術ではなく認知にあります。技術者の76%が「AIのコードは人間より安全だ」と回答した調査結果も報告されています。この認知が「自動化バイアス」、つまり自動生成された結果を無条件に信頼してしまう心理を生み、レビューの形骸化を招きます。
ここにトレードオフが発生します。AI駆動開発はコード生成速度を引き上げますが、レビュー速度は人間の処理能力に依存するため、据え置きのままとなります。生成速度がレビュー速度を上回ると、検査が追いつかず、未検証コードが本番へ流入してしまうでしょう。速度の利益が、そのまま検査負債として蓄積していく関係にあります。
AIの生産性を取り込みつつ、検査を律速段階にしない開発体制が、安全性担保の出発点となります。
情報漏洩はどこで起きる?AI駆動開発の3つの漏洩経路
情報漏洩は「AIを使うこと」自体ではなく、特定の3つの接点で発生します。漏洩経路を分解すると、入力・学習・出力の3段階に整理できます。各段階で防御策が異なるため、一括りの対策では漏れが生じてしまうでしょう。
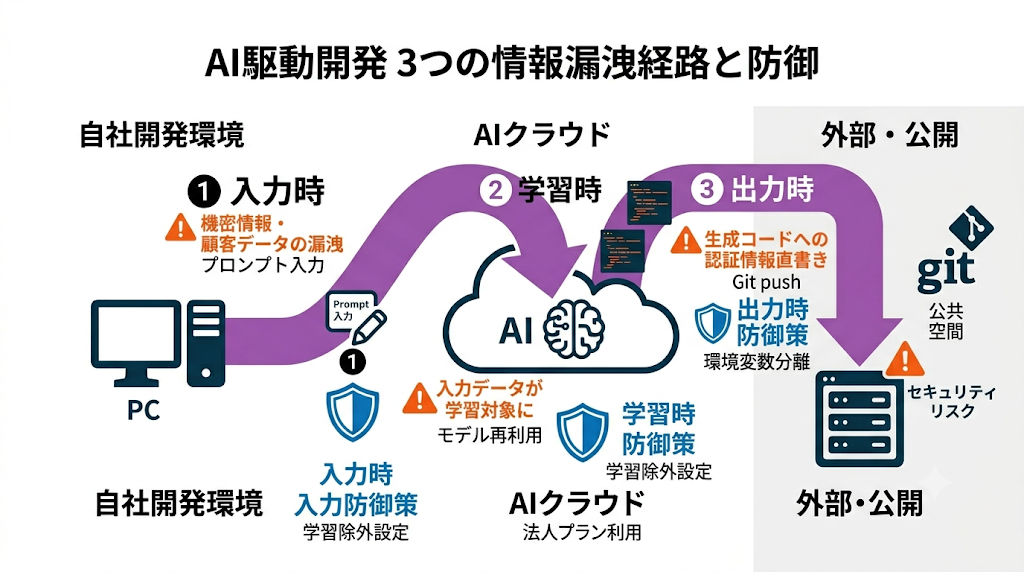
| 経路 | 漏洩する情報 | 発生タイミング |
|---|---|---|
| プロンプト入力 | 機密情報・個人情報 | AIへの指示送信時 |
| 学習再利用 | 入力データ全般 | 送信後のモデル学習時 |
| 生成コード埋め込み | 認証情報 | コード出力時 |
プロンプトへの機密情報入力による漏洩
最も発生頻度が高い経路が、プロンプトへの直接入力です。開発者が「このエラーを直して」とソースコードを貼り付ける、あるいは顧客データを例示として入力する行為が該当します。
因果は直線的です。機密情報をプロンプトへ入力すると、その情報はAIサービス提供者のサーバへ送信されます。送信先のデータ取り扱い規約次第で、保存・参照・学習の対象となってしまうわけです。
送信した時点で、情報は自社の管理境界を越えます。Microsoft Officeのドキュメントに埋め込まれた命令によってAIエージェントが機密情報を外部へ漏らす事例も報告されており、入力経路は人間の意図的な貼り付けに限りません。
入力データがAIの学習に再利用されるリスク
入力した情報がモデルの再学習に使われる場合、漏洩は二次的に拡大していきます。自社が入力したコードや顧客情報が、別の利用者への応答として出力されてしまう可能性も生じるでしょう。
この差異を分けるのは、利用するサービスのデータ取り扱い設定です。
| 区分 | 学習再利用 | 漏洩拡大リスク |
|---|---|---|
| 無料版・個人向けプラン | 再利用される場合が多い | 高 |
| 法人向け・API利用 | オプトアウト(学習除外)設定が可能 | 低 |
無料版のチャット型サービスをそのまま業務利用すると、入力データが学習対象となる前提で運用せざるを得ません。
法人向けプランやAPIであれば、学習除外を契約・設定で担保できるようになります。サービス選定の段階で、この設定可否が分岐点となるでしょう。
生成コードへの認証情報の埋め込み
出力段階の漏洩が、生成コードへの認証情報の直書きです。AIはアクセスキーやパスワードをコード内にハードコード(直接記述)するよう提案することがあります。
この危険が顕在化する典型が、生成コードをそのままバージョン管理システムへ登録する流れです。直書きされた認証情報を含むコードをGitリポジトリへ push すると、公開リポジトリの場合、認証情報が外部から取得可能になってしまいます。
攻撃者がそのキーでクラウド基盤へ侵入するわけです。AIは「動くコード」を優先するため、本来は環境変数や秘密情報管理ツールへ分離すべき認証情報を、コード本体へ埋め込む選択をとってしまいます。
プロンプト入力の運用ルール、学習除外設定の確認、生成コードの認証情報検査を、それぞれ独立した工程として配置することで、単一の対策に依存しない多層防御を構築できるようになります。
セキュリティ責任は誰が持つべきか|3つの役割分担モデル
AI駆動開発のセキュリティは、単一の担当者では成立しません。生成コードの検査、ツールの選定、利用の監査は、求められる権限と視点が異なるためです。責任を一点へ集約すると、検査が追いつかず形骸化してしまうでしょう。役割を3層へ分離し、各層に固有の責務を割り当てる構造が必要となります。
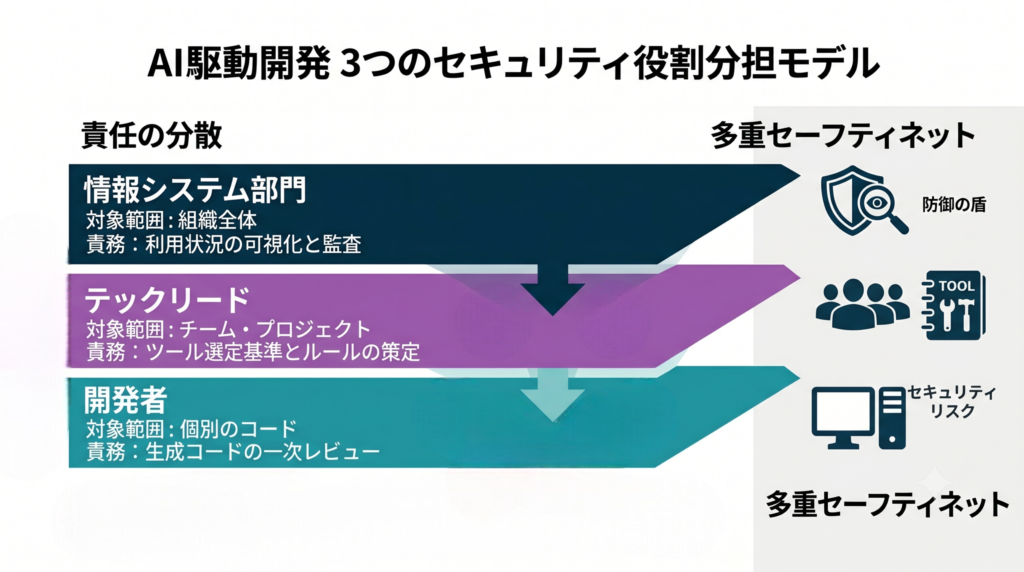
| 役割 | 責務 | 対象範囲 |
|---|---|---|
| 開発者 | 生成コードの一次レビュー | 個別のコード |
| テックリード | ツール選定基準とルールの策定 | チーム・プロジェクト |
| 情報システム部門 | 利用状況の可視化と監査 | 組織全体 |
開発者【生成コードの一次レビュー】
開発者の責務は、生成コードを本番へ移送する前の一次検査です。AIが「動く」を達成した出力に対し、安全性の評価軸を追加する役割を担います。
検査の焦点は、AI特有の死角に置きます。入力値検証の有無、認証情報の直書き、署名検証の実装、推奨パッケージの実在性。これらは標準のコードレビューでは「動作するため」見逃されやすい項目となります。
一次レビューを通過条件とすることで、未検証コードの本番流入を入口で遮断できるようになるはずです。開発者が最初の関門を担う理由は、コードの文脈を最も理解している立場にあるためです。
テックリード【ツール選定基準とルールの策定】
テックリードの責務は、個別のコードではなく、チーム全体が使うツールとルールの設計です。どのAIツールを許可し、どの設定で運用するかを定める層に位置します。
判断の中核は、ツールのデータ取り扱いです。学習除外設定の可否、データ保存先、契約上の機密保持。これらを評価基準として、利用可能なツールを選定していきます。
あわせて、プロンプトへ機密情報を入力しないルール、生成コードの検査手順を策定し、開発者の一次レビューが機能する前提条件を整備します。個々の開発者の判断に委ねず、チーム共通の基準へ昇格させることで、属人性を排除できるようになるでしょう。
情報システム部門【利用状況の可視化と監査】
情報システム部門の責務は、組織全体でのAI利用状況の把握と監査です。誰がどのツールを、どの目的で使っているかを可視化する層を担います。
ここで対処するのが「シャドーAI」、つまり管理外で個人が無断利用するAIツールのこと。可視化なき状態では、無料版チャットツールへの機密情報入力が組織のどこかで発生しても検知できません。
利用ログの収集、許可外ツールの検出、定期監査を通じて、テックリードが定めたルールの実効性を担保していきます。組織全体を俯瞰する権限を持つ部門が監査を担う理由は、部門横断での統制が必要なためです。
各層が独立した検査点として機能することで、一層が見逃したリスクを次層が捕捉する構造を実現できるようになります。
導入フェーズ別セキュリティ対応マップ
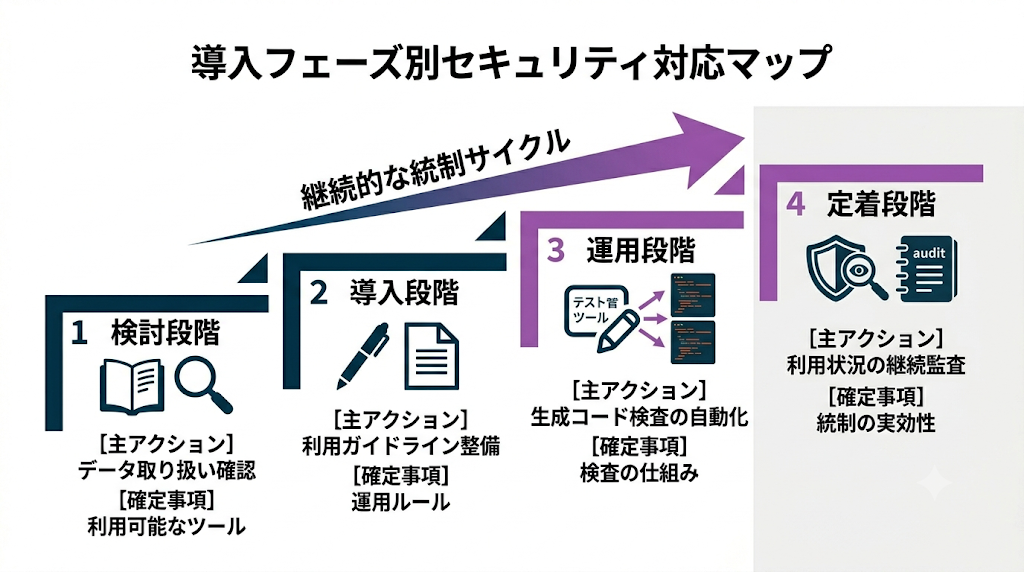
AI駆動開発のセキュリティ対策は、導入の進行度によって優先項目が変わります。検討段階で監査を論じても対象が存在せず、運用段階でツールのデータ取り扱いを論じても手遅れとなってしまうでしょう。各フェーズで「何を確定させるか」を順序立てて配置する必要があります。
| フェーズ | 主たる対応 | 確定させる事項 |
|---|---|---|
| 検討段階 | データ取り扱い確認 | 利用可能なツール |
| 導入段階 | 利用ガイドライン整備 | 運用ルール |
| 運用段階 | 生成コード検査の自動化 | 検査の仕組み |
| 定着段階 | 利用状況の継続監査 | 統制の実効性 |
検討段階──ツールのデータ取り扱い確認
最初に確定させるのは、ツールのデータ取り扱いです。導入後では契約変更のコストが発生するため、選定前の確認が前提となります。
確認項目は、学習除外設定の可否、入力データの保存先と保存期間、契約上の機密保持範囲。無料版・個人向けプランは学習再利用の対象となる場合が多く、業務利用の候補から除外する判断が妥当でしょう。
この段階の確認が、後続フェーズすべての前提条件を規定していきます。
導入段階──利用ガイドラインの整備
ツールを確定した後、利用ガイドラインを整備します。ツールが安全でも、使い方が無秩序であれば漏洩経路は残ってしまうためです。
ガイドラインに含める項目が以下です。
| 項目 | 規定内容 |
|---|---|
| プロンプト入力 | 機密情報・顧客データの入力禁止 |
| 認証情報 | 環境変数への分離を必須化 |
| 生成コード | 一次レビュー通過を本番移送の条件とする |
ルールを文書化することで、開発者の判断が属人化せず、検査基準を組織で統一できるようになります。
運用段階──生成コード検査の自動化
運用が始まると、生成コードの量が人手レビューの処理能力を上回ります。ここで検査を自動化へ移行しなければ、レビューが律速段階となり、形骸化してしまうでしょう。
自動化の対象は、SAST(静的解析)による脆弱性検出、シークレットスキャン(認証情報の直書き検出)、依存パッケージの実在性検証。これらをCI/CDパイプライン(コードの統合・配信の自動工程)へ組み込み、本番移送前の通過ゲートとして配置していきます。
人手レビューは自動検査が拾えない設計上の問題へ集中させる分業が成立するようになります。
定着段階──利用状況の継続的な監査
定着後の課題は、ルールが守られ続けているかの確認です。導入時のガイドラインは、時間経過とともに形骸化していきます。
継続監査の対象は、シャドーAIの検出、許可外ツールの利用、ガイドライン遵守状況。定期的なログ収集と監査を通じて、統制の実効性を維持していきます。監査結果をガイドラインへ反映する循環を設けることで、ルールが現場の実態から乖離しない状態を保てるようになるはずです。
この4フェーズは「導入の一度きりの作業」ではなく「継続的な統制サイクル」として設計されます。各フェーズの成果物が次フェーズの前提となる連鎖構造により、対策の抜けを防げるようになります。
AI駆動開発ならEPICs株式会社
「AI駆動開発で生産性を上げたいが、生成コードの安全性に不安がある」「過去にAI導入を進めたものの、レビュー体制が追いつかず断念した」。そうした課題をお持ちであれば、EPICs株式会社にご相談ください。
当社は、AI駆動開発を実践する開発企業です。AIによるコード生成速度と、人手レビューの処理能力の非対称性を前提に、生成コードの検査工程を開発フローへ組み込む体制を整えています。
開発の受託にとどまらず、「そのAIツールのデータ取り扱いは自社の機密保持要件を満たすか」というツール選定の段階からご支援。貴社の開発体制や既存のレビュー運用を丁寧に確認したうえで、検討・導入・運用・定着の各フェーズに応じたセキュリティ対応をご提案します。
開発者の一次レビュー、テックリードによるルール策定、情報システム部門の監査という役割分担の設計まで含め、要件定義から開発、運用定着、継続的な監査体制の構築まで一貫したサポート体制を整えています。
AI駆動開発のセキュリティ対策にお悩みの方は、まずはお気軽にご相談ください。貴社の開発体制に合わせた最適なご提案をいたします。
この記事を書いた人

関連記事
-
 AI駆動開発の本を「目的別」に厳選!全体像・実務・マネジメント・経営の1冊と実践法
-
AI駆動開発の事例4選!成功企業に共通する3つの条件と始め方を解説
-
AI駆動開発とは?従来開発との違い・メリット・リスク・始め方を体系解説
-
AI駆動開発と仕様駆動開発の違いとは?選定基準・使い分け方を実務視点で解説
-
AI駆動開発のベストプラクティス!フェーズ別の実践指針と組織への定着方法
-
AI駆動開発の要件定義!炎上を防ぐ5つの定義項目と発注側の役割
-
AI駆動開発IDEの選び方!Cursor・Copilot・Windsurf・Cline比較と導入の判断軸
-
AI駆動開発研修で生産性を伸ばす!ツール導入で終わらせないための手順


コメント