Claude Code エージェントチームとは|役割分担・コスト・構築手順をAI駆動開発会社が解説

単一のAIエージェントに開発を任せると、長時間のセッションで応答品質が劣化し、本来並列実行できるタスクでも待ち時間が発生してしまう問題が発生することがあります。
Claude Code エージェントチームは、この限界を「分業」で突破する仕組みです。1つのオーケストレーターがタスクを分解し、複数のサブエージェントが設計・実装・レビュー・テストを並列で担う構造により、人間の開発チームと同じ役割分担を機械上で再現します。
ただし、エージェント数に比例してトークン消費が膨らむため、誤った使い方をすると標準セッションの15倍のコストを払いながら速度向上を得られない事態も起こり得ます。
本記事では、エージェントチームの定義と単一エージェントとの違いから、導入前に直視すべきコスト構造、4つの基本ロールの設計図、.claude/agents/配下の定義ファイルとオーケストレーターの具体的な構築手順までを、実務上のトレードオフとともに整理します。
どのタスクが並列化に向き、どのタスクが向かないのか。その判断基準を持ち帰っていただける内容です。
Claude Code エージェントチームとは何か。単一エージェントの「限界」が生んだ発想
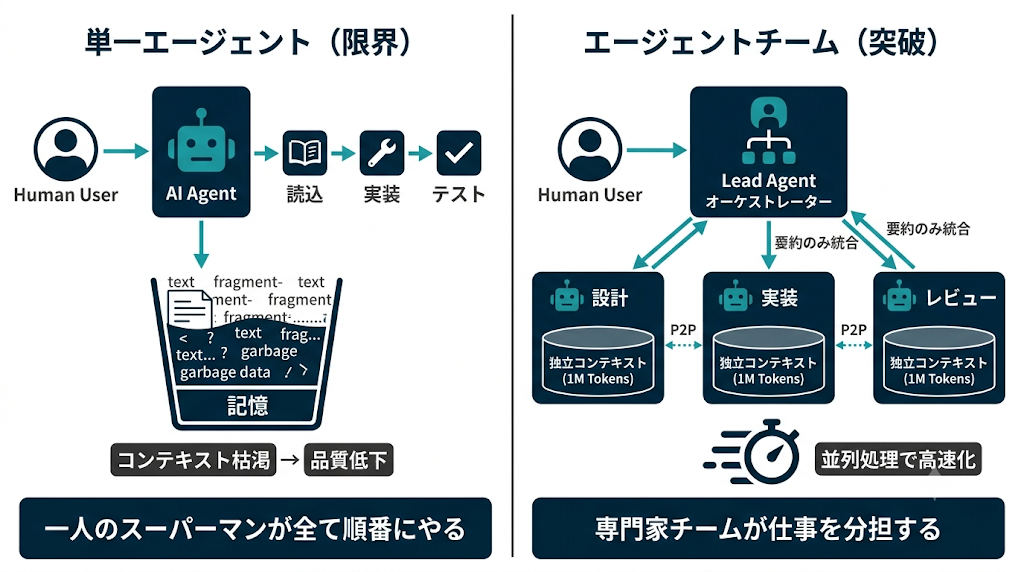
Claude Code エージェントチームとは、1つのオーケストレーター(指揮役)が開発タスクを分解し、複数のサブエージェント(作業役)に並列で割り振る開発手法のこと。単一のAIに1ファイルずつ順番に処理させる従来型とは異なり、人間のエンジニアチームと同じ「分業」を機械上で再現する仕組みです。
Anthropicは2026年のCode with Claudeイベントで、この多エージェント連携を正式機能として位置づけました。リード(指揮)エージェントがジョブを分割し、各サブエージェントが独自のモデル・プロンプト・ツールを持って共有ファイルシステム上で並列稼働、結果をリードのコンテキストへ集約する構造となっています。
重要なのは、この発想が「エージェントを増やせば賢くなる」という量の論理ではなく、「コンテキストという有限資源をどう配分するか」という資源配分の論理から生まれた点にあります。
エージェントチームの定義|複数エージェントによる役割分担型開発
エージェントチームは、Claude Code内で稼働する複数のClaudeインスタンスを協調動作させる枠組みです。1つのセッションが「チームリード」として計画・タスク割当・結果統合を担い、各「チームメイト」は独立したコンテキストウィンドウ(つまりAIが一度に保持できる作業記憶の領域のこと)で動作します。
サブエージェントとの決定的な違いは、コミュニケーション経路にあります。サブエージェントはリードに報告するのみですが、エージェントチームのメンバーは相互に直接やり取りでき、ユーザーもリードを介さず個別のチームメイトと対話できる設計となっています。
| 構成要素 | 役割 | コンテキストの扱い |
|---|---|---|
| オーケストレーター(リード) | タスク分解・割当・結果統合 | 各メンバーの要約のみ受領 |
| サブエージェント | 報告型の単発作業 | 独立。リードへ最終要約を返却 |
| チームメイト | 相互通信する協調作業 | 独立。メンバー間で直接共有 |
なお2026年4月時点で、エージェントチームは実験的機能(CLAUDE_CODE_EXPERIMENTAL_AGENT_TEAMS=1の設定が必要)であり、セッション再開・タスク調整・終了処理に既知の制約を残す段階にあります。本番導入では、この実験的ステータスを前提に設計しておく必要があるでしょう。
単一エージェントが抱える3つの制約
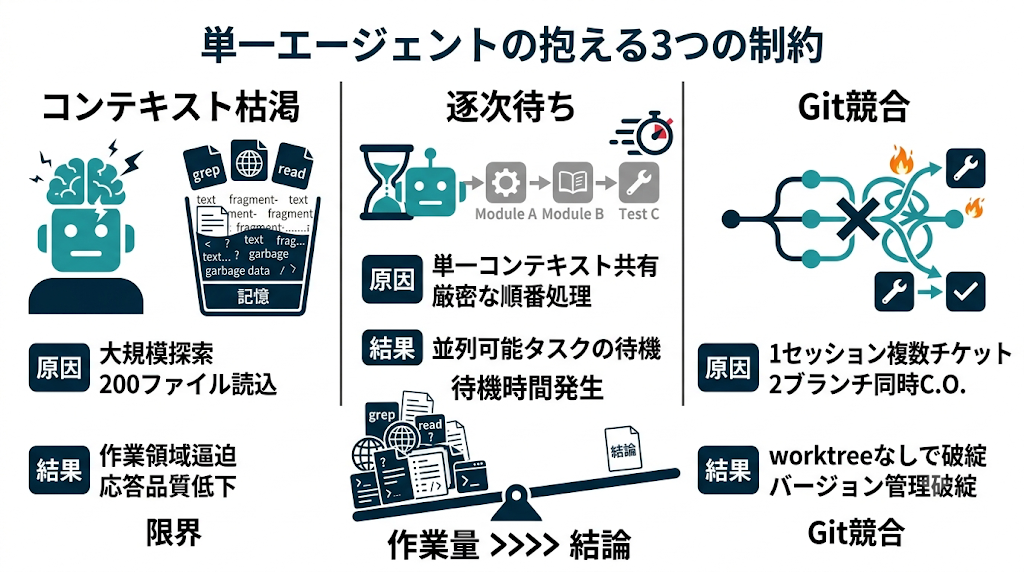
単一エージェントが大規模・並列性の高いタスクで機能不全に陥る理由は、以下の3点です。
1つ目はコンテキスト枯渇です。単一エージェントが200ファイルを読んでから変更を加えるタスクでは、ファイル読み込みが進むほどコンテキストが消費され、判断に必要な情報を取り込み終えた頃には作業領域が逼迫し、応答品質が低下してしまいます。
2つ目は逐次処理の構造的限界です。単一エージェントは1つのコンテキストウィンドウを全タスクで共有し、厳密に順番に作業するため、本来並列実行できる独立タスク(複数モジュールへの同時改修など)でも待ち時間が発生してしまいます。
3つ目はGit版管理の競合です。1セッションで複数チケットを同時に進めると、2つのブランチを同時にチェックアウトする状況が生まれ、worktree(作業ツリーの分離)設定なしでは破綻してしまうでしょう。
| 制約 | 発生原因 | 結果 |
|---|---|---|
| コンテキスト枯渇 | 探索作業が結論より大きい | 応答品質の低下 |
| 逐次処理 | 単一コンテキストの共有 | 並列可能タスクの待機 |
| Git競合 | 1セッション複数ブランチ | バージョン管理の破綻 |
この3制約の根底にある原理は1つで、「タスクが生む作業量は、その結論より遥かに大きい」という非対称性です。エージェントチームは、この作業量を隔離されたコンテキストへ押し出し、結論だけを本流へ返すことで制約を回避していきます。
オーケストレーター型と並列分担型の違い
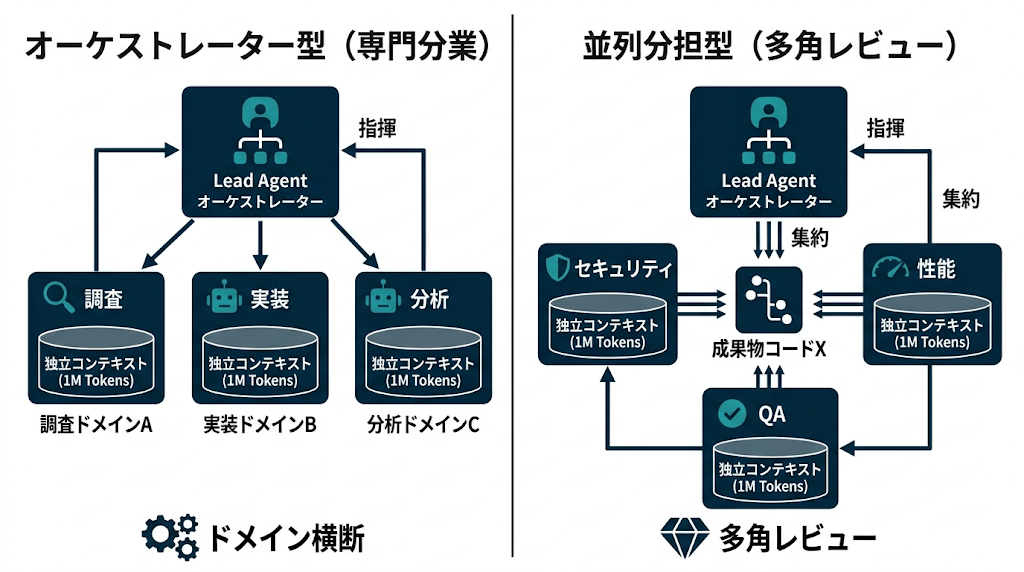
多エージェント構成は、タスクの依存関係によって2系統に分かれます。
オーケストレーター型(ルーティング型)は、指揮役がタスク種別に応じて専門サブエージェントへ振り分ける構造です。調査タスクは調査用、実装タスクは実装用、分析タスクは分析用へ送られ、汎用エージェント1体より高品質な出力を、複数ドメインにまたがるワークフローで実現できるようになります。
並列分担型(ファンアウト型)は、独立した複数タスクを同時に走らせ、結果を集約する構造です。「fan out → reduce → synthesize(拡散→集約→統合)」が一般化する形であり、複数の異なる視点で同一成果物をレビューさせる「パネル方式」もこの系統に含まれます。
| 観点 | オーケストレーター型 | 並列分担型 |
|---|---|---|
| タスク依存 | あり(種別で振り分け) | なし(独立タスク) |
| 適合作業 | 複数ドメイン横断 | 大規模・分割可能な作業 |
| 代表パターン | ルーティング | ファンアウト・パネルレビュー |
| トレードオフ | 振り分け精度に品質依存 | 要約統合のオーバーヘッド |
両者は排他ではありません。実務では、オーケストレーターがファンアウトを併用し、依存タスクは連鎖(チェーン)、独立タスクは並列という使い分けが標準形になりつつあります。
人間の開発チームとの対応関係
エージェントチームの構造は、人間の開発チームの分業を機械上に写像したものです。リードが作業を分解し、専門家が各自の担当を独立して進め、結果をレビュー・マージするという流れが一致します。
| 人間チーム | エージェントチーム | 機能 |
|---|---|---|
| テックリード | オーケストレーター | 計画・分解・統合 |
| 各担当エンジニア | サブエージェント | 隔離された担当範囲の実装 |
| レビュアー | レビュー用サブエージェント | 差分の検証 |
| QA | テスト用サブエージェント | テスト実行・カバレッジ確認 |
ただし対応関係には限界もあります。人間チームは暗黙知や口頭の文脈共有で齟齬を埋めますが、エージェントチームはメンバーが返す「要約」のみで連携するため、要約に落ちた情報は欠落してしまいます。
この情報の非対称性こそが設計上の最大の変数であり、後述するコンテキスト共有の設計がチーム機能の成否を分けることになるでしょう。要約設計は「指示書の粒度」として標準化し、欠落リスクを抑える運用を推奨します。
導入前に知るべきコスト構造とトークン消費の現実
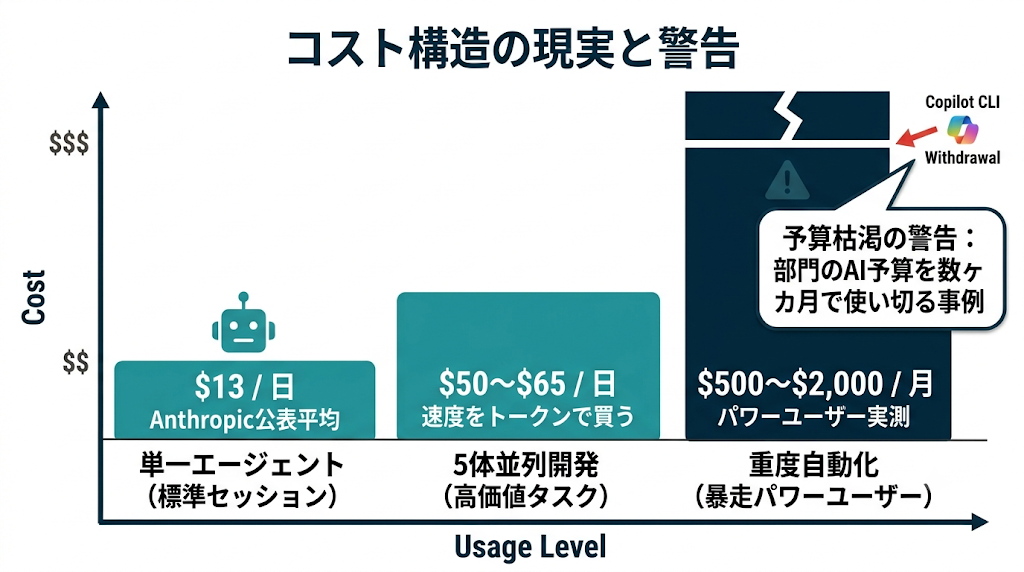
エージェントチームの最大のトレードオフはトークン消費です。各チームメイトが独立したコンテキストウィンドウを持つため、消費量は人数と稼働時間に比例して増加していきます。Anthropicは、チームメイトがプランモードで稼働する場合、標準セッションの約7倍のトークンを消費すると示しています。
加えて2026年6月のAnthropic料金改定により、コスト構造は二重化しました。6月15日にAgent SDKとヘッドレス実行(claude -p)がフラットプランから切り離され、API従量課金のクレジットプールへ移行しています。
Microsoftが2026年6月、パワーユーザーのトークン課金が月額500〜2,000ドルに達し部門のAI予算を数ヶ月で使い切ったとして、Claude Code利用を停止しGitHub Copilot CLIへ移行したと報じられました。コスト管理を設計に組み込まない限り、青天井になる構造を直視しておく必要があります。
トークン消費がエージェント数に比例する仕組み
トークン消費がエージェント数に比例する理由は、コンテキストの分離構造にあります。各チームメイトは独立した1Mトークンのコンテキストウィンドウを持ち、それぞれが独立してトークンを消費していきます。10体の並列エージェントは、Pro・Max・Enterpriseのトークン枠を10倍速で消費してしまうでしょう。
ただし「比例」は最良ケースです。実際には3つの要因で消費が比例を超えていきます。
| 増加要因 | 仕組み | 影響度 |
|---|---|---|
| 並列数 | 各エージェントが独立して消費 | 線形(人数倍) |
| 相互通信 | メールボックス経由のメッセージ往復 | 人数増で逓増 |
| 結果統合 | サブエージェント応答がリードへ還流 | 複利的に増加 |
各ツール呼び出しがコンテキストを追加し、各サブエージェントの応答がオーケストレーターへ還流するため、多エージェント系のコストは線形ではなく複利的に膨らむ性質を持っています。
Anthropicは、多エージェント系が単一チャットの約15倍のトークンを消費し得るとしており、経済性が成立するのは高価値かつ分割可能なタスクに限られると言えるでしょう。
単一エージェントとのコスト比較(試算)
2026年6月時点の公開API料金を基準に試算します(モデル別、入力/出力100万トークンあたり)。
| モデル | 入力 | 出力 | 用途 |
|---|---|---|---|
| Haiku 4.5 | $1 | $5 | 高頻度・軽量タスク |
| Sonnet 4.6 | $3 | $15 | 標準コーディング |
| Opus 4.8 | $5 | $25 | アーキテクチャ判断 |
| Fable 5 | $10 | $50 | 最難関タスク |
Anthropicの企業向け公表値では、Claude Codeのコストは開発者1人あたり1稼働日13ドル、月150〜250ドルとなっています。ここに並列実行が乗ると数字が変わります。同じく公表されている平均値で試算すると、5体の同時稼働は1日あたり50〜65ドルに達することになります。
| 構成 | 1稼働日のコスト目安 | 前提 |
|---|---|---|
| 単一エージェント | 約13ドル | Anthropic公表平均 |
| 5体並列 | 50〜65ドル | 平均値×並列係数 |
| 重度自動化 | 月500〜2,000ドル | パワーユーザー実測 |
数字が示す結論は1つで、エージェントチームは「速度をトークンで買う」仕組みであり、削減した人間の工数が増加トークンコストを上回る場合にのみ経済合理性を持つということです。EPICsでは、PoC段階で「タスク1件あたりの実コスト(cost per task)」を計測し、人件費換算と突き合わせてから本番並列化を判断する手順を採用しています。
コストが膨らむ典型パターン
トークンコストが想定を超える典型パターンは、以下の3点です。
1つ目は全エージェントへの最上位モデル割当です。すべてのサブエージェントを最も高価なモデルへ振り分ける「過剰購入」が、ファンアウトを非経済化する最速の経路となってしまいます。高頻度かつ範囲の明確なサブタスクはSonnetなど低コストモデルへ、フロンティアモデルはオーケストレーターの計画と難所のみに限定する設計が前提になるでしょう。
2つ目は過剰な並列数です。3〜5体が大半のワークフローの最適域であり、これを超えると要約のマージに費やす時間が並列で得た時間を侵食してしまいます。15の独立タスクなら3体が適正な起点で、「集中した3体は、散漫な5体を上回る」が運用則となっています。
3つ目は密結合タスクへの誤適用です。各変更が前の変更に依存する密結合の作業へエージェントチームを適用すると、調整オーバーヘッドとマージ競合が速度向上を打ち消してしまいます。
| 典型パターン | 発生原因 | 回避策 |
|---|---|---|
| 全エージェント最上位モデル | モデル選定の怠慢 | タスク別にモデルをルーティング |
| 過剰並列 | 「多いほど速い」誤認 | 3〜5体に制限 |
| 密結合への適用 | タスク特性の誤判定 | 単一エージェントで連鎖処理 |
適用可否の判定基準として有効なのが「各サブタスクを、それ以上の会話なしで別々のエンジニアへ渡せるか」という問いです。
渡せるなら分割可能であり、エージェントチームに適合します。渡せないなら、単一エージェントが端から端まで推論する方が安価かつ確実と言えるでしょう。
エージェントの役割分担|設計・実装・レビュー・テストの設計図
役割分担の設計とは、開発工程をMECEに分解し、各工程を独立したコンテキストへ割り当てる作業のこと。オーケストレーターは自らコードをほとんど編集せず、リクエストを分解し、並列実行可能な範囲を判断し、明確な指示でサブエージェントを起動し、返ってきた結果を統合していきます。
各サブエージェントは独自のコンテキスト・ツール・目的を持つ別個のClaude Codeインスタンスであり、リードへ返すのは完全な思考過程ではなく簡潔な要約のみとなります。
この非対称な情報フローこそが設計の核心であり、リードのコンテキストを「grep結果の再読」ではなく「指揮」のために確保してくれます。
4つの基本ロール(設計・実装・レビュー・テスト)
開発工程を4ロールに分解します。具体的には、以下の4点です。
設計ロールは、要件を技術仕様へ変換する役割です。実装着手前にアプローチを概説し、20回のツール呼び出しにまたがって誤りが複利的に増える前に、方向性の誤りを捕捉してくれます。
実装ロールは、仕様に基づきコードを生成する役割です。独立したファイル群を担当し、他ロールと干渉しない範囲で並列稼働します。
レビューロールは、差分を検証する役割です。ここで威力を発揮するのが「パネル方式」(複数の異なる視点で同一成果物を検査する手法のこと)。セキュリティ・パフォーマンス・テストカバレッジを別々のエージェントが同時に検査し、単一レビュアーが見逃す失敗モードを捕捉できるようになります。
各エージェントは他が何を発見したか知らないため、その盲目性が多様性を生むことになります。
テストロールは、テスト実行とカバレッジ確認を担う役割です。
| ロール | 担当範囲 | 推奨モデル | 出力 |
|---|---|---|---|
| 設計 | 要件→技術仕様 | Opus 4.8 | 設計方針・分解案 |
| 実装 | コード生成 | Sonnet 4.6 | 差分(コミット) |
| レビュー | 差分検証 | Sonnet 4.6 | 指摘・検証結果 |
| テスト | テスト実行 | Haiku 4.5〜Sonnet | カバレッジ・合否 |
ロールごとの担当範囲と指示の与え方
指示設計の原則は、ロール間で担当範囲を重複させないことです。レビュー用プロンプトでは、各エージェントに別個の「レンズ」(観点)を割り当て、重複を防いでいきます。
指示の与え方は2系統に分かれます。再利用する専門家は.claude/agents/へ定義ファイルとして配置し、固定のシステムプロンプトとツールを持たせます。1回限りの作業は、その場のTask呼び出しで処理しましょう。リードは定義ファイルのdescription文字列を読んで、いつ委任するかを判断してくれます。
| 指示方法 | 適合作業 | 特性 |
|---|---|---|
| 定義ファイル(.claude/agents/) | 反復する専門作業 | 固定プロンプト・ツール |
| Task呼び出し(その場) | 1回限りの作業 | リードの文脈を継承 |
指示文には、担当ファイル範囲・使用ツール・出力形式・禁止事項を明記しておきましょう。ツール記述を省略すると全ツールが付与される(「なし」ではない)点に注意が必要であり、最小権限の原則を適用するなら各ロールへ必要なツールのみを明示的に割り当てておくと安心です。
タスク受け渡しとコンテキスト共有の流れ
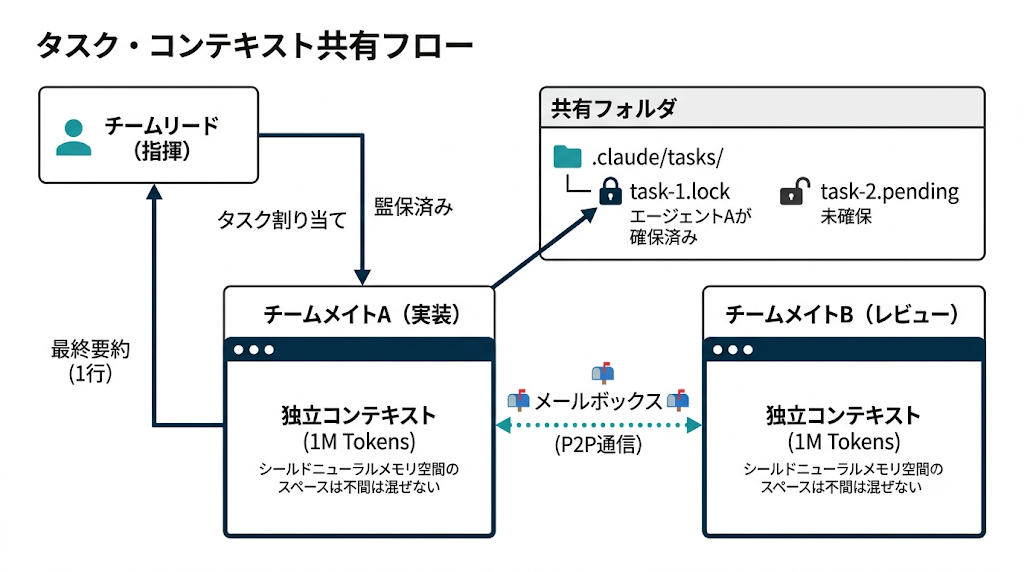
エージェントチームのコンテキスト共有は、2つの機構で動作します。共有タスクリスト(ロックファイル方式)と、メールボックス経由のピアツーピア・メッセージングです。
タスク管理は.claude/tasks/配下のロックファイルで実現します。エージェントAがtask-1.lockを確保すると、他エージェントは未確保のtask-3.pendingへ向かい、作業の二重取りを防いでくれます。
| ファイル状態 | 意味 |
|---|---|
| task-1.lock | エージェントAが確保済み |
| task-2.lock | エージェントBが確保済み |
| task-3.pending | 未確保(次の担当待ち) |
重要な訂正として、エージェント間連携はリードの統合のみを経由するわけではありません。各エージェントのコンテキストウィンドウは分離(1Mトークン)されたまま、メールボックス機構を介して相互に直接メッセージを送る設計となっています。
この「分離されたコンテキスト+明示的メッセージング」が、情報の独立性と協調を両立させてくれます。
ただし共有されるのは明示的に送られた情報のみです。エージェントが要約に落とさなかった文脈は他へ伝わらないため、インターフェース・契約・公開APIに触れる作業では、誤った前提のコストが取得コストを上回ってしまうでしょう。
役割分担が機能するケース・しないケース
役割分担の成否は、タスクの分割可能性で決まります。
| 観点 | 機能するケース | 機能しないケース |
|---|---|---|
| タスク構造 | 独立・並列可能 | 密結合・逐次依存 |
| 具体例 | 複数サービス改修・カバレッジ網羅・広範な調査 | 同一ファイル編集・連鎖する変更 |
| 価値の源泉 | 並列探索が価値を生む | 単一の推論連鎖が確実 |
| コスト判断 | 各サブタスクが追加トークンを正当化 | 調整コストが速度向上を相殺 |
機能するのは、新規モジュール・機能(各メンバーが独立部分を所有)、競合仮説のデバッグ(複数理論を並行検証して収束)、フロント・バック・テストにまたがる横断変更(各層を別メンバーが所有)などです。
一方、機能しないのは逐次タスク・同一ファイル編集・依存関係の多い作業です。これらは単一セッションかサブエージェントの方が効果的でしょう。
多エージェント系は「普遍的なアップグレード」ではなく、作業が真に並列で、各サブタスクの価値が追加トークンコストを正当化する場合に限り効果を発揮します。この前提を外すと逆効果になりかねません。
実際の構築手順!設定ファイルとサブエージェント定義の作り方
構築の核心は2層構造です。再利用する専門家を.claude/agents/配下のMarkdown定義ファイルとして配置し、それらを束ねるオーケストレーターの振る舞いをCLAUDE.mdで規定します。
サブエージェントはMarkdownファイルにYAMLフロントマター(ファイル冒頭のメタデータ領域のこと)を付与した形式で、フロントマターが設定、本文がシステムプロンプトとして機能します。
なお複数セッションを協調させるエージェントチームは実験的機能であり、本番ワークフローでは「サブエージェント+オーケストレーター」の構成が安定しています。本節はこの構成を前提に手順を示します。
前提環境と必要な準備
着手前に確認すべき前提は、以下の3点です。
1つ目はClaude Codeの稼働環境です。CLI(コマンドライン)またはIDE統合で動作するターミナルツールであり、既存のClaudeプラン(Pro・Max・Team)またはAPIキー経由で課金されます。
2つ目は配置スコープの選択です。サブエージェント定義は2箇所に置けます。
| スコープ | 配置場所 | 適用範囲 | 優先順位 |
|---|---|---|---|
| プロジェクト | .claude/agents/ | そのリポジトリのみ | 高(同名時に優先) |
| ユーザー | ~/.claude/agents/ | 全セッション | 低 |
チームで共有する役割はプロジェクトスコープへ配置し、Gitへコミットすることで、メンバー間で同一定義を共有・改善できるようになるでしょう。
3つ目はモデルルーティングの方針決定です。コスト最適化の大半はモデル選定で決まるため、着手前にロール別の割当を確定させておきましょう。
環境変数CLAUDE_CODE_SUBAGENT_MODELは最優先で全サブエージェントのモデルを固定し、コスト上限やコンプライアンス要件の担保に使えます。
サブエージェント定義ファイルの作成手順
定義ファイルは/agentsコマンドによるガイド付き生成が推奨されますが、構造を理解するため手動作成の形式を示します。
フロントマターの各フィールドは以下の役割を持っています。
| フィールド | 役割 | 省略時の挙動 |
|---|---|---|
| name | エージェント識別名 | 必須 |
| description | リードが委任判断に読む説明 | 必須 |
| tools | 使用可能ツールの許可リスト | 全ツール継承(「なし」ではない) |
| model | 実行モデル(sonnet/opus/haiku/inherit) | inherit |
toolsフィールドの挙動が最大の注意点となります。指定すればそのツールのみに制限され、省略すると全ツールを継承してしまいます。レビュー用エージェントにWriteを与えない、といった最小権限の設計には、必要ツールの明示が欠かせません。
ロール別の推奨ツール構成を整理します。
| ロール | 推奨ツール | model |
|---|---|---|
| 設計(Architect) | Read, Grep, Glob | opus |
| 実装(Implementer) | Read, Write, Edit, Bash, Grep, Glob | sonnet |
| レビュー(Reviewer) | Read, Grep, Glob, Bash | sonnet |
| テスト(Tester) | Read, Bash, Grep | haiku〜sonnet |
descriptionは委任精度を左右します。「Use this agent when…」や「use proactively」といった行動指示で始めることで、リードが委任タイミングを認識しやすくなるはずです。本文(システムプロンプト)には、役割・担当範囲・出力形式・完了条件(Definition of Done)を明記しておきましょう。
サブエージェントは完全なClaude Codeシステムプロンプトを受け取らず、この本文と作業ディレクトリ等の基本情報のみを受け取るため、必要なルールは本文へ明記しておく必要があります。
なお、ディスク上で直接ファイルを追加・編集した場合は、読み込みのためセッションの再起動が必要です。/agentsインターフェース経由なら即時反映されます。
オーケストレーターの設定方法
オーケストレーターの振る舞いはCLAUDE.md(プロジェクトルートに置く永続メモリファイルのこと)で定義します。記述すべきは、タスクの分解方針・起動するサブエージェント種別・検証方法の3点です。複雑なタスクを投入すると、Claude Codeがこの規定に従い自動でオーケストレーションを実行してくれます。
委任の指示は2方式あります。
| 方式 | 記述例 | 用途 |
|---|---|---|
| 名前指定 | 「code-reviewerサブエージェントで差分を確認」 | 特定ロールの明示呼出 |
| 並列指示 | 「5体のエージェントで重複・複雑度・デッドコードを並列分析」 | ファンアウト |
運用安全のため、Human-in-the-loop(人間の承認を介在させる仕組みのこと)を組み込む構成が有効です。SubagentStopフック(サブエージェント終了時に発火するシェル連携のこと)で次の推奨コマンドを出力し、人間が承認してから次工程へ進める設計にすることで、暴走的な連鎖を防げるようになります。
フックは、テスト合格・差分への秘密情報混入なし・範囲外ファイルへの書込みなしといった非交渉的な制約を、リードが結果を統合する前に強制する用途にも使えます。
動作確認とデバッグの進め方
動作確認は段階的に進めましょう。
| 手順 | コマンド/操作 | 確認内容 |
|---|---|---|
| 1. 定義の登録確認 | /agents(Libraryタブ) | 全サブエージェントの登録状態 |
| 2. 単体起動 | 名前指定で1体を呼出 | 担当範囲・出力形式の妥当性 |
| 3. 稼働監視 | /agents(Runningタブ) | 稼働中・完了の状態 |
| 4. 使用量確認 | /usage | トークン消費の実測 |
デバッグの起点は、応答品質の劣化です。長時間セッションでは、約95%容量で自動コンパクション(履歴を要約へ置換する処理のこと)が作動しますが、これは可逆ではなく情報欠落を伴います。サブエージェントへ探索作業を逃がし、リードのコンテキストを清浄に保つことが、品質劣化への根本対処になるでしょう。
デバッグの実務指針は3点です。
/usageで都度トークン消費を計測し、想定との乖離を早期に検知すること。- 5体の並列探索的読み込みはProプランで20分以内にレート上限へ到達し得るため、並列数を段階的に増やしていくこと。
- 定義ファイルが「埃をかぶる」(Claude単体が十分に処理するため呼ばれなくなること)事態を避けるため、
descriptionを反復改善し委任精度を維持すること。
AI駆動開発ならEPICs株式会社
「Claude Code エージェントチームを導入したいが、自社のどのタスクが並列化に向くか判断できない」「複数エージェントの並列実行でトークンコストが想定を超えないか不安」。そうしたお悩みをお持ちであれば、AI駆動開発を手がけるEPICs株式会社にご相談ください。
当社は、AI駆動開発を実務として手がける開発企業です。単なる構築の受託にとどまらず、「そもそもエージェントチームによる並列化が、その業務に最適な手法なのか」という課題の整理段階からご支援します。
本記事で示したとおり、多エージェント構成は密結合タスクでは調整コストが速度向上を相殺し、単一エージェントの方が安価かつ確実なケースもあります。
AI駆動開発の導入についてお悩みの方は、まずはお気軽にご相談ください。貴社の開発体制と課題に合わせた最適なご提案をいたします。
この記事を書いた人

関連記事
-
 【Claude Code の使い方】インストールから運用まで|AIに任せる範囲と人が確認する範囲の線引き
-
Claude Codeの料金を完全解説|全プラン比較とAPI従量課金の損益分岐【2026年最新】
-
Claude Codeとは?ターミナルで動く自律型AIエンジニアの仕組みと導入の実務
-
Claude Codeでできること完全ガイド|効果を出す見極め方と3つの落とし穴
-
Claude Code 無料枠の真実。常設プランがない理由と”実質無料”で試す現実的な方法
-
Claude Code × VSCode連携の全体像|ターミナル版との違い・対応環境・用途別の使い分け
-
Claude Code Webとは?ターミナル不要でAIにコードを書かせる仕組みと向き不向き
-
Claude Codeの音声入力「/voice」完全ガイド!日本語が認識されない原因と設定手順


コメント